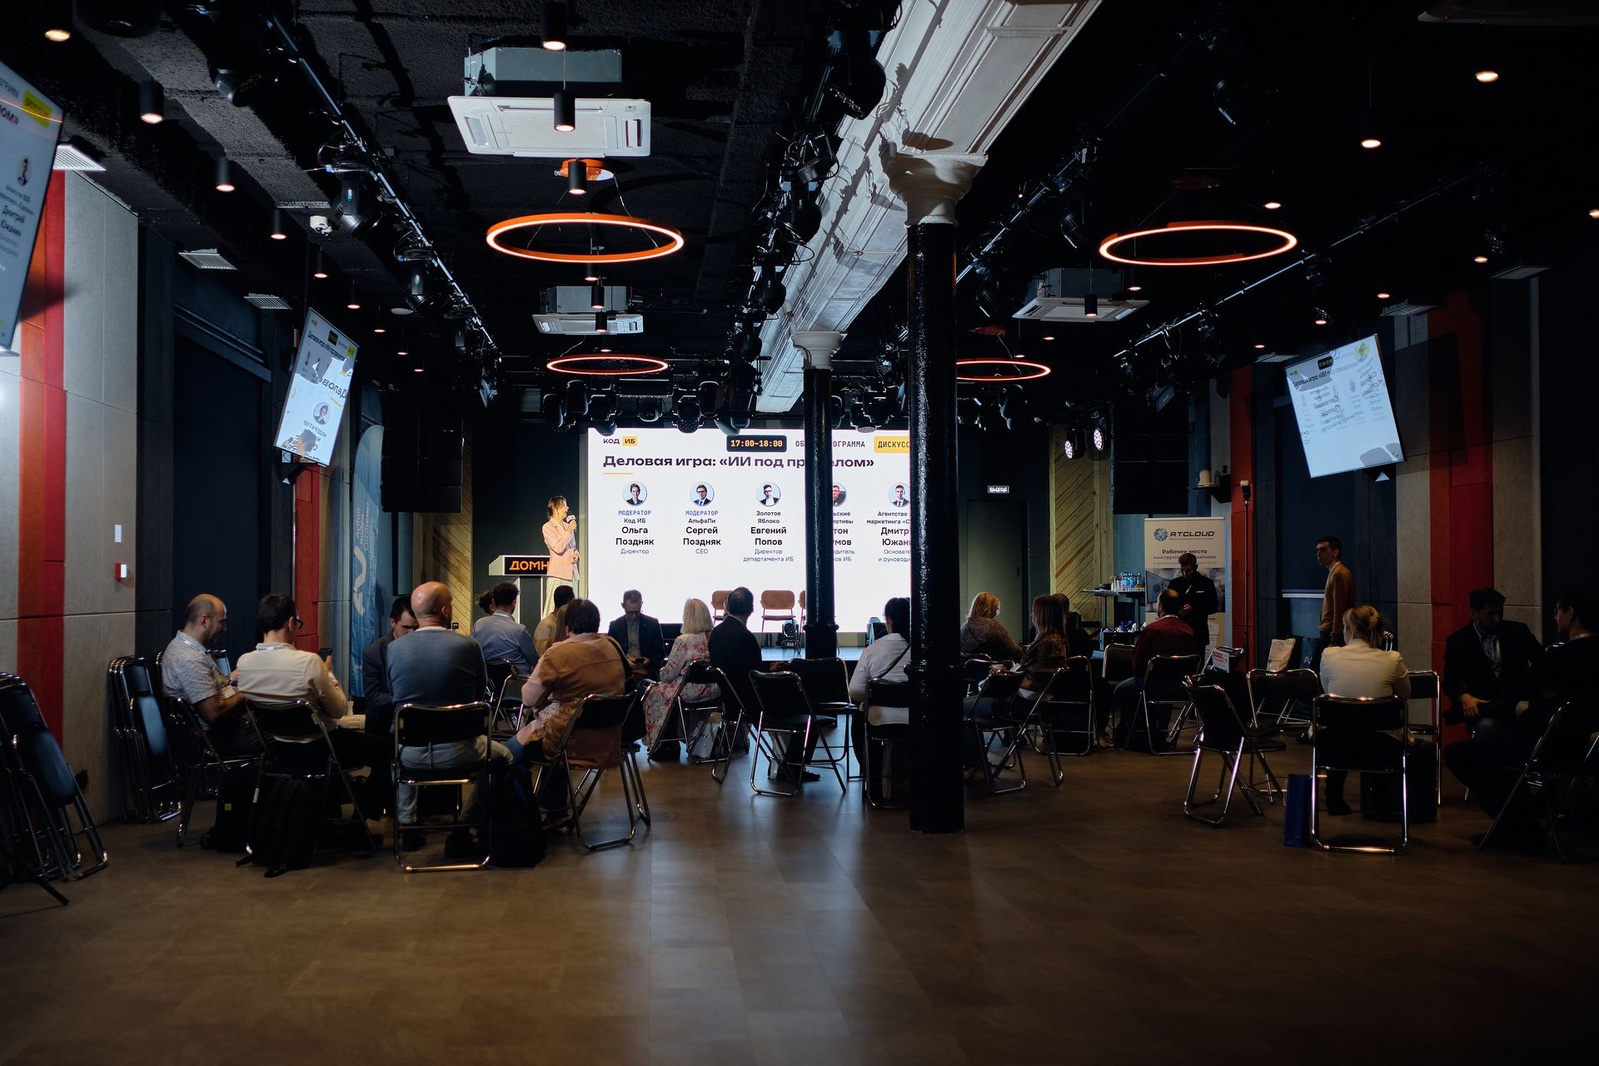
Материалы конференции · 15 октября 2026, четверг · 09:30–18:00

Код ИБ Екатеринбург 2026: тезисы, записи и презентации

Главное из выступлений конференции на одной странице: ключевые тезисы каждого доклада по порядку программы.

Код ИБ | Екатеринбург 2026 Код ИБ | Екатеринбург 2026 Код ИБ | Екатеринбург 2026
17
выступлений
12
записей
2
зала

Выступления конференции

Все доклады с тезисами — по порядку программы.

01
10:30 · 60 минут

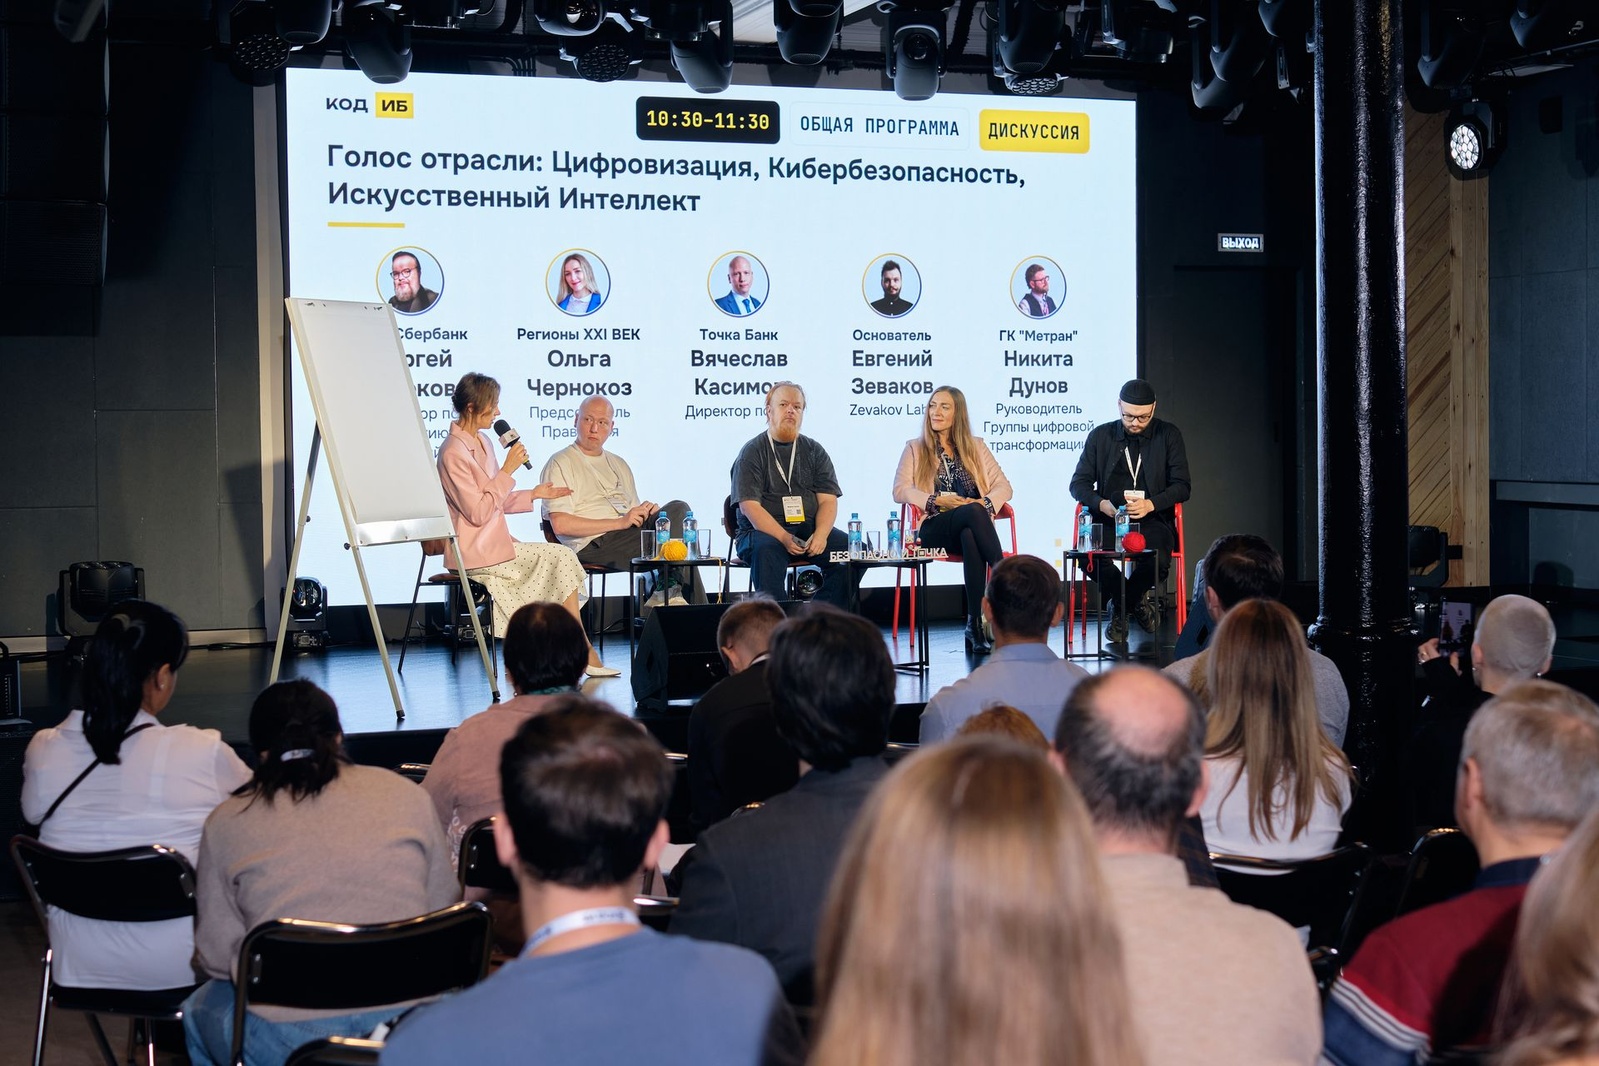
Голос отрасли: Цифровизация, Кибербезопасность, Искусственный Интеллект
Сергей Марков
Сергей Марков
Директор по развитию технологий ИИ, ПАО Сбербанк
Ольга Чернокоз
Ольга Чернокоз
Председатель Правления Ассоциации инновационных решений и искусственного интеллекта «Регионы XXI ВЕК», Член cовета ТПП РФ по развитию информационных технологий и цифровой экономики, учредитель и основатель IT-медиахолдинга "Регионы России", Регионы XXI ВЕК
Вячеслав Касимов
Вячеслав Касимов
Директор по ИБ, Точка Банк
Евгений Зеваков
Евгений Зеваков
Основатель Zevakov Labs, постоянный эксперт Ассоциации инновационных решений и искусственного интеллекта «Регионы XXI ВЕК», Zevakov Labs
Никита Дунов
Никита Дунов
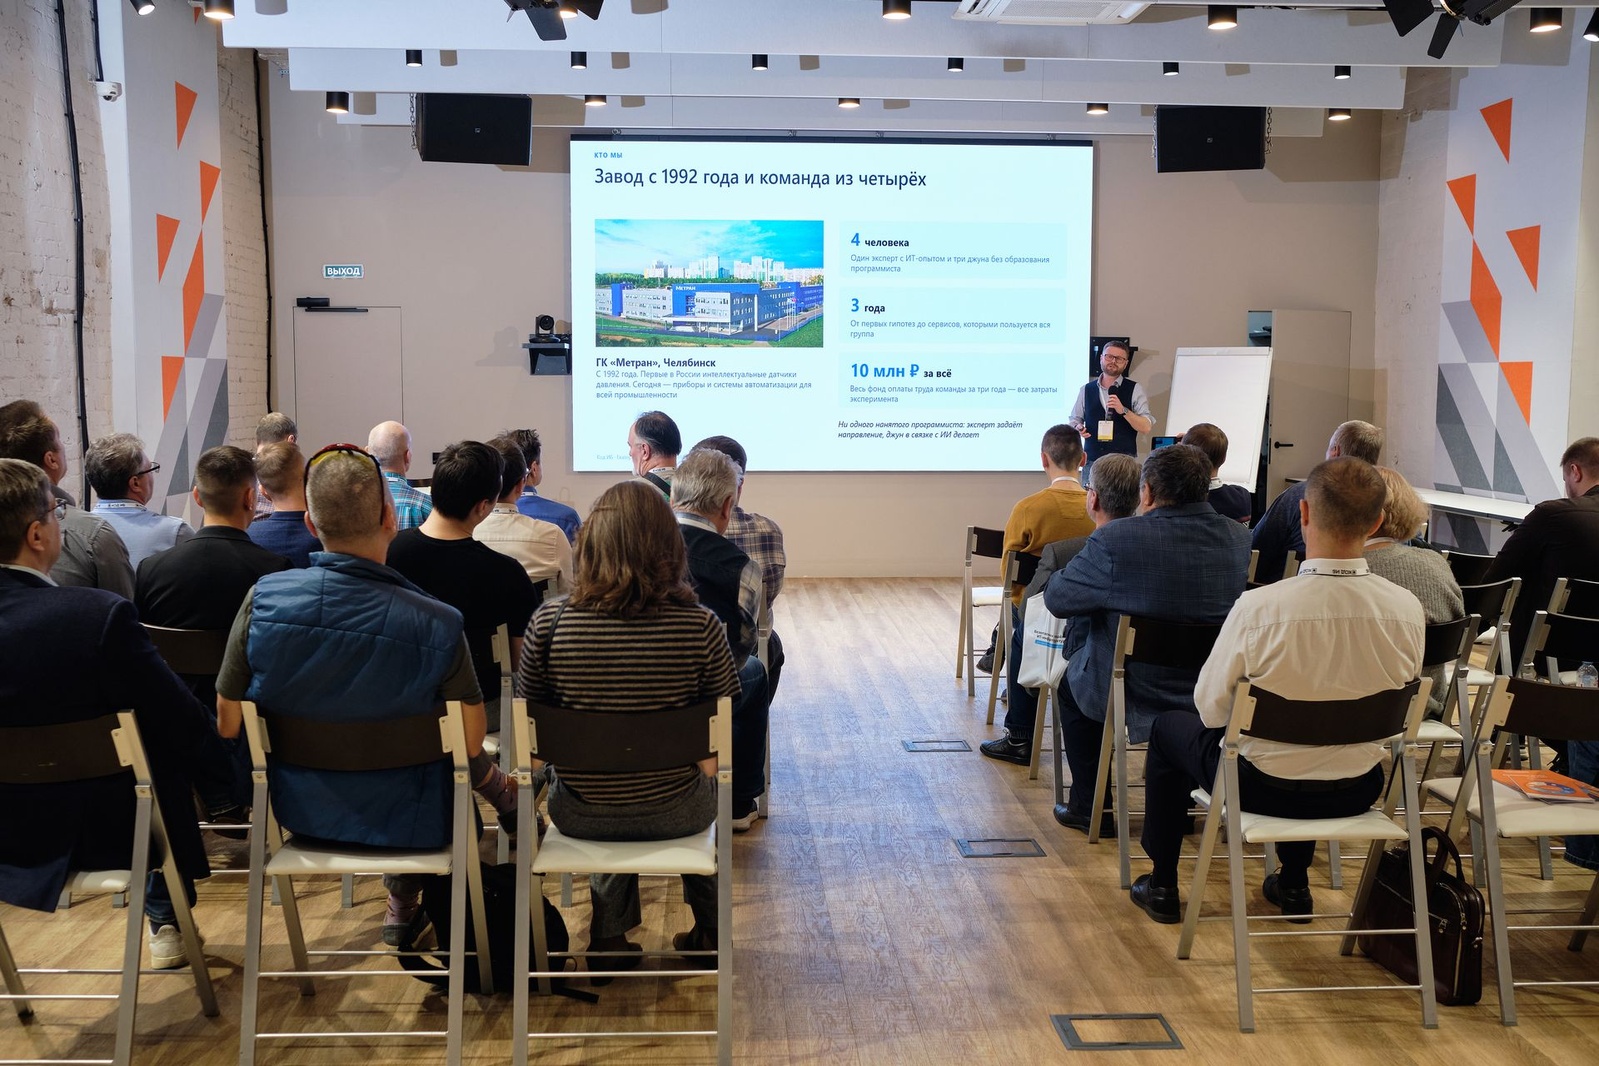
Руководитель Группы цифровой трансформации, ГК "Метран"

ИИ в кибербезопасности — нейтральный инструмент, но он ускоряет гонку снаряда и брони

Сергей Марков (ПАО Сбербанк) подчёркивает: ИИ — это область науки и технологий для автоматизации интеллектуальных задач, и сама технология нейтральна. Как молотком можно заколачивать гвозди или разбивать головы, так и ИИ в кибербезопасности может использоваться и защищающимися, и атакующими. Автоматизированные системы для атак, аудита, выявления уязвимостей и защиты применяются очень давно, поэтому прогресс не стоит воспринимать как мгновенный скачок: часто агентные системы просто проверяют то, до чего у людей не доходили руки.

При этом быстрый прогресс меняет модель угроз и создаёт новые вызовы. Нельзя расслабиться: если в гонке снаряда и брони защищающаяся сторона отстаёт, это обернётся против неё. Нужно рационально относиться к инструментам, понимать изменения модели угроз и быстро двигаться в технологическом развитии.

Предприятия ищут доверенный контур внедрения ИИ и бесплатный аудит процессов

Ольга Чернокоз рассказала, что возглавляемая ею ассоциация выстраивает доверенный контур внедрения искусственного интеллекта в российских регионах и на промышленных предприятиях. Она объединяет экспертов по ИИ, предприятия, внедряющие технологии, и IT-/ИИ-компании с готовыми решениями. Фокус — работа именно с предприятиями, а не с органами госвласти, где всё сложнее.

Интерес проявляют и промышленность, и малый-средний бизнес, но есть опасения: многие уже «накололись» на красивые обещания разработчиков и ищут доверенный контур. Ассоциация совместно с федеральным центром компетенции Минпромторга собирает верифицированные кейсы — их более ста, в том числе в каталоге Минцифры. Через региональные центры компетенций (РЦК) при правительствах ассоциация помогает пройти бесплатный аудит и определить процессы для автоматизации; если готового решения нет, задача передаётся разработчикам.

Бизнес осторожно внедряет агентов, начиная с простых и «незаменяемых» функций

Евгений Зеваков (Zevakov Labs) отмечает: экономические сложности диктуют первоочередные задачи — секретарские функции, документооборот и всё, что с ними связано. Но хайп вокруг агентов приводит к запросам от руководителей: почему часть работы до сих пор делают люди? Если полгода назад звучало «заменим 5 секретарей на 2», то сейчас спрашивают: «у нас 10 инженеров-экологов, можем ли оставить 3 и сделать систему, которая сама готовит экологическую экспертизу?»

Это сложные задачи, но в некоторой степени уже решаемые. Предприятия внедряют агентные системы очень осторожно, ограниченно, под контролем — но в сферы, которые год назад казались абсолютно незаменяемыми. Ольга Чернокоз привела пример из промышленности: разбор конструкторской документации и определение комплектующих, чем раньше занимались огромные проектные отделы, теперь может выполняться очень быстро.

Агента нужно воспринимать как сотрудника: разграничение прав, минимум доступов и контроль внешних каналов

Вячеслав Касимов (Точка Банк) предупреждает: как только в LLM загружают большие данные о компании и клиентах, она становится многопользовательской, а тем более получает доступ в интернет — риски резко возрастают. В обычной системе есть чёткие правила доступа, и корректная программа не даёт выйти за рамки. В многопользовательском ИИ доступы размываются: либо архитектурно продуманы изолированные домены, либо получается «коммунальная квартира». Дополнительно есть специфический набор угроз — OWASP Top 10 для генеративных моделей и агентских решений.

Сергей Марков и Евгений Зеваков сходятся: агента следует умозрительно рассматривать как сотрудника компании. Доступы к ERP и внутренним ресурсам надо разграничивать по той же логике, что и для человека: чем меньше возможностей и прав, тем лучше. Выход во внешний интернет для внутреннего агента — по возможности лишний функционал; если он нужен, следует использовать шлюзы и ограничения. Для оборонных предприятий риски выше: логи запросов во внешние модели могут быть доступны третьим сторонам, поэтому разумно разворачивать open source в закрытом контуре и закрывать фаерволами. Универсальных рецептов нет: нужно сопоставлять риски, цену атаки и меры контроля.

Готовые AI-файрволы уже появляются, но защиту можно переиспользовать или строить самим

На вопрос о готовых решениях Вячеслав Касимов ответил, что есть два пути. Первый — найти готовое решение: интеграторы уже предлагают «AI-файрволы», у кого-то они работают, у кого-то нет. Второй — сделать самому. В любом случае нужно понимать особенности своей инфраструктуры и использования ИИ. Если речь о внешних моделях, крайне нежелательно, чтобы в них попадала чувствительная информация, поэтому нужен шлюз. Но если обращение идёт через веб, разницы с обычным уходом на Google Диск может не быть: в компании и так должен работать DLP. Не нужно выращивать из ИИ «могучую химеру» — это такое же приложение, просто с другими алгоритмами. Можно переиспользовать накопленные процессы защиты.

Евгений Зеваков добавляет: организационные меры сами по себе бесполезны, нужны технические. Его команда планирует выпустить в open source библиотеку для обезличивания данных и юридического оформления, включая ведение реестра по требованиям Роскомнадзора. Внешних готовых решений мало; часто это допиленное решение Microsoft, адаптированное под российские данные, но есть риск пропустить важное из-за особенностей русского языка. Своё решение вполне реально.
Тезисы проверены редакцией · 28.10.2026
02
Зал 1 · 12:00 · 20 минут

Диалог с регулятором. Роскомнадзор.

Ярослав Федулов
Ярослав Федулов
Начальник отдела контроля и надзора за соблюдением законодательства в сфере персональных данных, Управление Роскомнадзора по Уральскому федеральному округу

Оборотные штрафы за утечки персональных данных заработали, и суды поддерживают Роскомнадзор

С прошлого года вступили в силу изменения об оборотных штрафах за утечки персональных данных. Практика нарабатывается успешно: суды поддерживают доводы Роскомнадзора, поэтому вопрос ответственности встаёт перед операторами всё острее.

Оборотный штраф введён за утечку обычной категории данных, специальной категории (чаще сведения о состоянии здоровья), биометрии и за повторные утечки. Новые составы — части 12–18 КоАП, их применение зависит от количества субъектов в базе. Но по специальным категориям и биометрии количественного критерия нет: ни регулятор, ни суд не станет учитывать численность субъектов при таких утечках.

На объектах КИИ с обработкой персональных данных действует мультипликатор ответственности

Для объектов КИИ, где обрабатываются персональные данные, действует мультипликатор ответственности: контроль идёт и по линии ФСТЭК (187-ФЗ), и по 152-ФЗ. Если ИСПДн является ещё и объектом КИИ, будьте готовы, что на вас направят взор сразу два регулятора.

Речь о требованиях 127-го и 1119-го постановлений Правительства и приказе ФСТЭК № 21. Ответственность есть как по КоАП, так и по Уголовному кодексу. Лица, работающие с такими объектами, больше подвержены рискам, чем ответственные за обработку данных в базовой ИСПДн, где речь идёт только о 152-ФЗ и КоАП.

За действия подрядчика административную ответственность несёт владелец информационной системы

Если информационную систему обслуживает подрядчик, эти работы рассматриваются как поручение на обработку персональных данных, и ответственность изначально лежит на владельце объекта. При уязвимости у подрядчика вопросы придут к владельцу: оператор отвечает и за его действия, а к подрядчику требования можно предъявить лишь в рамках Гражданского кодекса.

Поручение по части 3 статьи 6 закона о персональных данных должно обеспечивать защиту данных по статье 19, и рекомендуется фактически проверять защищённость: на практике виновным признавали оператора, когда вход в его ИСПДн был возможен через уязвимость подрядчика. То же с облачными решениями: при использовании, например, облачного решения 1С по кадрам отвечает оператор, а контрагент — только перед ним.

Основной вектор надзора — проверки сайтов без взаимодействия с контролируемым лицом

Ключевой вектор надзора Роскомнадзора — мероприятия по контролю без взаимодействия с контролируемым лицом. Они регулируются постановлением № 1046, а не 248-м ФЗ, и проводятся без уведомления: о проверке оператор узнаёт из требования об устранении нарушения со сроком 10 рабочих дней. Неисполнение грозит ответственностью, чаще всего по части 1 статьи 13.11 КоАП.

Анализируется фактическое содержание формы сбора данных на сайте по отношению к согласию под ней: если в форме собираются должность, адрес, дата рождения, а в согласии их нет, встаёт вопрос об избыточных данных и отсутствии правовых оснований. Если договор или закон уже предусматривают обработку, накладывать сверху согласие не рекомендуется.

Также выявляется отсутствие политики обработки персональных данных и избыточные сроки: согласие на 75 лет избыточно, к тому же при передаче документов в архив действие 152-ФЗ прекращается. Для распространения данных нужно отдельное согласие по приказу Роскомнадзора № 18.

Хранение баз данных вне России и использование Google форм ведут к штрафам в миллионы

Строгое требование части 5 статьи 18 закона о персональных данных: при сборе персональных данных хранение и последующая обработка должны обеспечиваться с использованием баз данных на территории Российской Федерации. Любое иное решение — автоматический триггер для выявления нарушения и основание для дела по части 8 статьи 13.11 КоАП, где штраф для юрлиц измеряется в миллионах.

Отдельно стоит вопрос Google форм: их использование формально не запрещено, но хранение идёт на иностранных серверах (данные из России отправляются на сервер в Ирландии), то есть фактически используется иностранная база данных. Это также триггер для дела по части 8 статьи 13.11 КоАП.

Вход на сайт через иностранные сервисы запрещён — введён состав по статье 13.55 КоАП

Требования 149-го федерального закона по способам авторизации на сайте уже действуют, и таких способов четыре: номер телефона, госуслуги, единая биометрическая система либо российская информационная система. Вход через иностранные сервисы — Apple ID, аккаунты Google — под запретом.

За это введён состав по статье 13.55 КоАП. В отличие от статьи 13.11 здесь есть различие по процедуре: протокол также составляет Роскомнадзор, но рассматривает материалы старший государственный инспектор — должностное лицо Роскомнадзора.

Тезисы проверены редакцией · 28.10.2026
03
Зал 2 · 12:00 · 60 минут

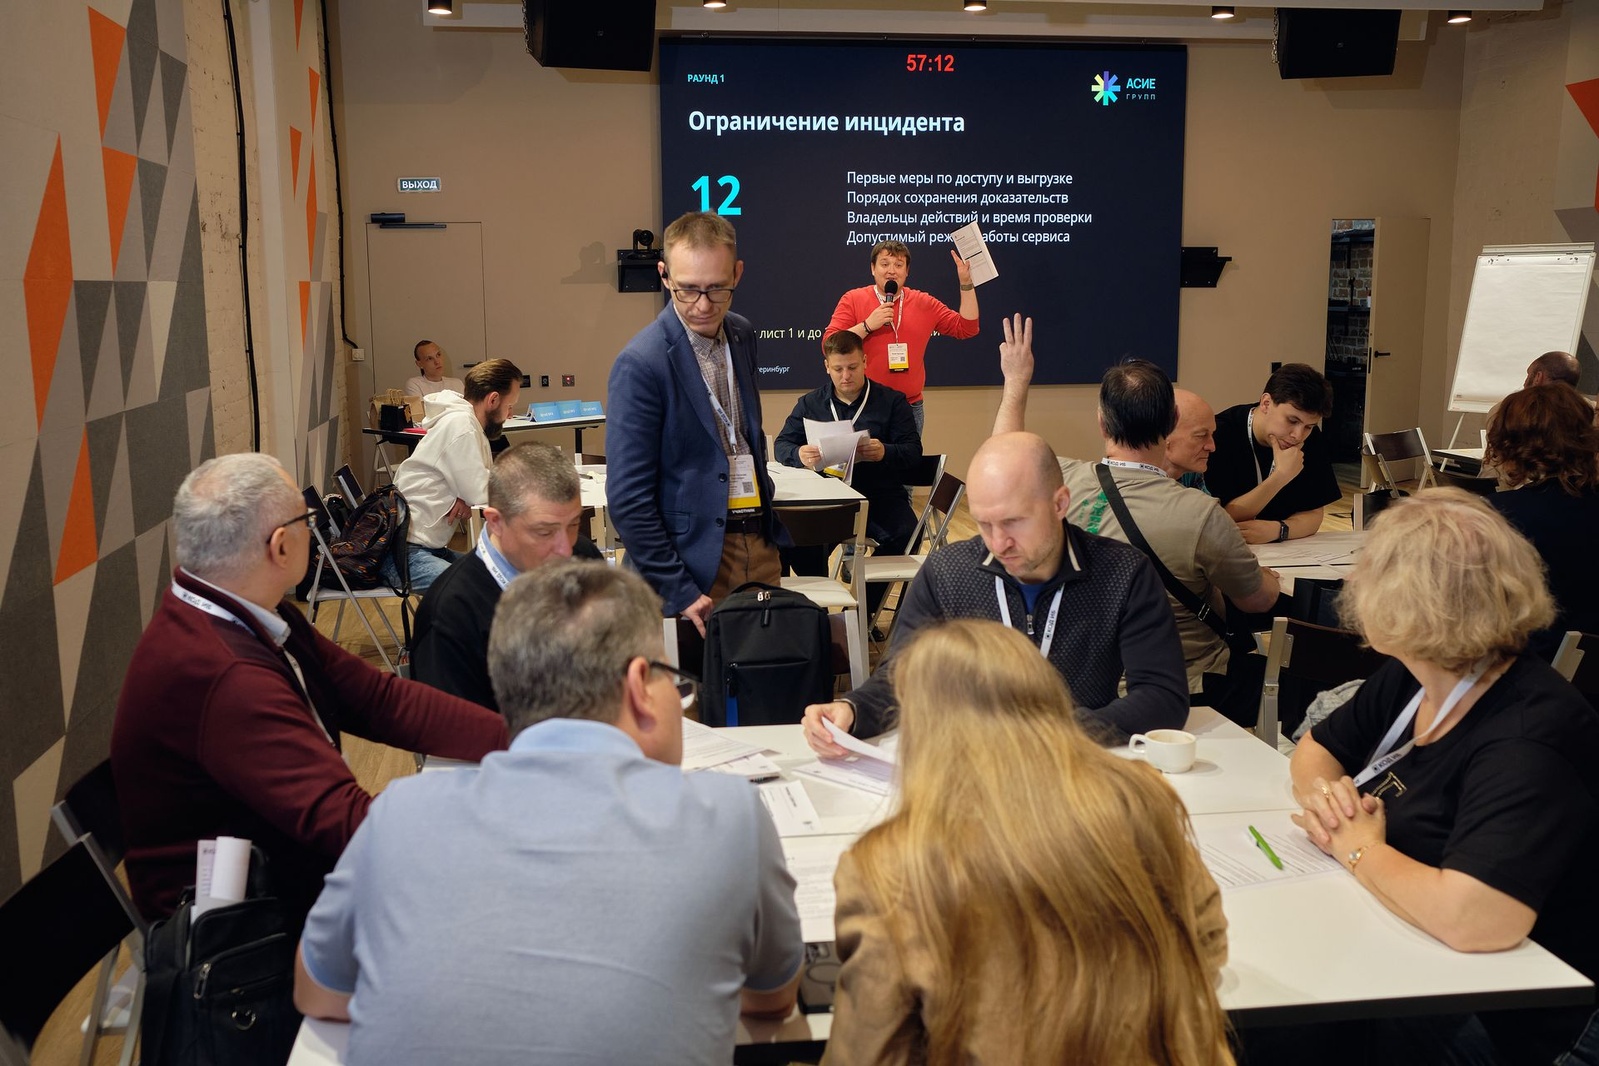
Бизнесс игра: "Кризисный штаб"

Арсений Бенин
Арсений Бенин
Коммерческий директор, АСИЕ-Групп

Утечка базы через подрядчика: исходная точка игры

Сценарий игры — собирательный, из реальных инцидентов. Вы управляете кризисным штабом вымышленного сервиса, принимающего заказы в приложении и на сайте, а подрядчик сервиса поддерживает портал обратной связи и выгрузку данных. В 9:00 появляется сообщение о продаже клиентской базы: в открытом доступе образец на 200 строк с персональными данными, и он совпадает с частью клиентских обращений.

Штабу нужно ограничить доступ к данным, сохранить доказательства и определить безопасный режим работы бизнеса, указав конкретный ограничиваемый доступ и способ проверки результата. Инцидент считается выявленным в 9:00.

Сначала фиксация следов, а не переустановка сервера

Подрядчик готов переустановить сервер, но до уничтожения его локальных журналов должно произойти сохранение доказательств. Отдельно штаб решает, что можно остановить, не прерывая приём заказов: команда на защите объясняла, что сервер нельзя сносить, потому что на нём есть следы, нужно задействовать альтернативные каналы и уведомить об этом пользователей.

Второй принцип — не смешивать установленный факт и оценку. К 12:00 в журнале 48 тысяч строк, но подтверждены лишь 200 строк образца, а сколько людей затронуто — неизвестно. Именно от этого разделения зависит объём проверки, который запускает штаб.

Главный урок: подрядчику — только необходимые данные

Ключевой вывод разбора: подрядчику нужно давать исключительно те данные, которыми он будет пользоваться, — не больше. Если есть возможность, распределить их между двумя-тремя подрядчиками так, чтобы ни у кого не было целой картины.

Отдельная сложность — модель SaaS: если база существует в решении подрядчика, регулировать объём передаваемых данных трудно, поэтому задачу надо изначально описывать подробнее.

Меры классические: правило 3-2-1, двухфакторная аутентификация, распределение информационных ресурсов. Как сформулировал ведущий, нет ничего сложнее, чем самое простое.

Публичное сообщение, легитимный канал и риск мошенников

Штабу нужно подготовить сообщение объёмом до 60 слов, определить канал публикации, подписанта и следующую контрольную точку, учесть обращения клиентов и риск мошеннических сообщений. В игре клиенту приходит SMS со ссылкой на оплату и фразой про «компенсацию за утечку»: клиент должен понимать, какой канал легитимный и куда переходить не стоит.

Команда, защищавшая решение, честно назвала принятый риск: частичная приостановка сервиса, изменение поведения пользователя, возможное падение числа заявок. Клиентам сообщили о сложностях, не став их обманывать.

Закрыть все экспортные каналы и не оставить старый токен

В третьем раунде нашёлся отдельный токен задания выгрузки — при первом решении один из каналов выгрузки остался не закрыт. Логика проверки: если все ключи подрядчика либо все экспортные каналы охвачены и мера исполнена (коды A02 и A03), запрос вторым токеном отклоняется, иначе он проходит. Штабу нужно свериться с фактическим текстом первого решения: закрыт ли этот путь и какая проверка подтверждает результат.

Отдельный сюжет — возврат к обычному режиму: бизнес просит запуск, но в копии остался старый токен. Штаб определяет, какой тест даёт право на запуск, кто согласует решение и что станет причиной отката.

Параллельные процессы и тщательная фиксация решений

В кризисе действия приходится выстраивать параллельно: пока инцидент развивается, штаб одновременно ограничивает доступ, сохраняет доказательства, готовит сообщение клиентам и проверяет остаточный доступ. По опыту участников, времени на ознакомление и распределение ролей не хватает — и это отражает реальность.

Второй акцент — документирование: при передаче материалов в компетентные органы доказательства нужно фиксировать максимально тщательно. Судьи оценивали не только содержание, но и оформление, а победила команда с наиболее подробными протоколами.
Тезисы проверены редакцией · 28.10.2026
Код ИБ | Екатеринбург 2026 Код ИБ | Екатеринбург 2026 Код ИБ | Екатеринбург 2026
04
Зал 1 · 12:20 · 20 минут

Диалог с регулятором. НКЦКИ.

Юрий Зубаиров
Представитель, НКЦКИ

С 2025 года обязанности по взаимодействию с ГосСОПКА расширены и распространены на руководителей госорганов и организаций независимо от наличия объектов КИИ

Представитель НКЦКИ Юрий Зубаиров напомнил, что с момента вступления в силу Федерального закона 58 в 2025 году сфера действия 187-го Федерального закона о безопасности КИИ существенно расширилась. У субъектов КИИ появились новые обязанности, в частности обязанность сообщать в ГосСОПКА о компьютерных атаках. Обязанности по взаимодействию с ГосСОПКА распространились также на руководителей государственных органов и организаций: они попадают под действие закона независимо от наличия у них объектов КИИ.

В январе 2026 года вступили в силу 7 приказов ФСБ, направленных на совершенствование правового и организационного обеспечения функционирования ГосСОПКА. Цель изменений — повышение эффективности взаимодействия между субъектами КИИ, НКЦКИ, центрами ГосСОПКА и органами государственной власти всех уровней.

Приказ 546 вводит обязанность сообщать в НКЦКИ об атаках на других субъектов КИИ в течение 12 часов

Приказ 546 устанавливает порядок обмена информацией о компьютерных атаках и компьютерных инцидентах между субъектами КИИ внутри страны, а также между субъектами КИИ и зарубежными ведомствами и организациями в области реагирования на компьютерные инциденты.

Новая обязанность: если субъект КИИ получает информацию о компьютерных атаках и инцидентах, связанных с функционированием объектов КИИ другого субъекта, он обязан проинформировать НКЦКИ не позднее 12 часов с момента получения такой информации. Обмен с иностранными и международными организациями осуществляется через НКЦКИ, за исключением случаев, предусмотренных отдельными нормативно-правовыми актами и международными договорами Российской Федерации.

Приказ 547 задает сроки информирования НКЦКИ: 3 часа для значимых объектов КИИ и 24 часа в остальных случаях

Приказ 547 определяет сроки направления материалов в НКЦКИ. Для субъектов КИИ при наличии значимых объектов КИИ срок направления информации о компьютерном инциденте — 3 часа. Для иных объектов КИИ — 24 часа. Срок направления информации о компьютерных атаках — 24 часа. Для руководителей государственных органов срок информирования о компьютерных атаках и инцидентах — 24 часа.

Если проектом плана реагирования предусмотрено привлечение подразделений и должностных лиц ФСБ России, проект плана и изменения направляются не в головное подразделение ФСБ России, а в Центр защиты информации и специальной связи ФСБ России. Если план не содержит необходимости привлечения сотрудников ФСБ, копия плана направляется в НКЦКИ в течение семи календарных дней после утверждения.

Приказ 548 обязывает подключиться к инфраструктуре НКЦКИ для непрерывного взаимодействия с ГосСОПКА

Приказ 548 устанавливает правила непрерывного взаимодействия с ГосСОПКА для субъектов КИИ, а также для руководителей государственных органов и организаций. Непрерывное взаимодействие осуществляется посредством подключения к технической инфраструктуре НКЦКИ. Субъекты КИИ, имеющие значимые объекты КИИ, а также государственные органы и организации обязаны подключиться к инфраструктуре НКЦКИ.

Ранее используемые каналы, такие как почтовые электронные адреса и обычная почта, используются только при наличии технических сбоев или отсутствии связи с личным кабинетом. Подключение осуществляется после заключения регламента взаимодействия; порядок описан на сайте ГосСОПКА.ру. Сейчас действует упрощенный порядок заключения регламента — посредством присоединения.

НКЦКИ разграничивает компьютерную атаку и компьютерный инцидент: квалификация зависит от наличия последствий

Понятия «событие ГосСОПКА» не существует; есть термины «компьютерная атака» и «компьютерный инцидент». На примере ДДОС-атаки на публичный сайт, когда ресурсы в локальной сети не пострадали, нужно уточнить, было ли нарушено функционирование сайта. Если да — это компьютерный инцидент, если нет — компьютерная атака. Если сайт или DNS-сервер является частью объекта КИИ, информация направляется в установленные сроки; если не является, обязанности нет, но НКЦКИ рекомендует направлять сведения для общей картины и предупреждения других субъектов.

СОК обнаружил 50 тысяч попыток эксплуатации уязвимости маршрутизаторов, но успешных эксплуатаций нет — это компьютерная атака. При наличии последствий событие становится компьютерным инцидентом. Уведомления о компьютерной атаке необходимо направить в НКЦКИ.

Практические разъяснения НКЦКИ: момент обнаружения, инциденты по вине сотрудников, блокировка IP и сбор логов

Моментом обнаружения компьютерного инцидента считается выявление последствий или начало мер реагирования. Если специалисты изначально обнаружили факты несанкционированного доступа или изменение конфигурации, но изменения не зафиксированы, моментом обнаружения считается выявление несанкционированного доступа. Если ресурсы на аутсорсинге у центра мониторинга ГосСОПКА и центр выявил атаку в 2 часа ночи, а сообщил в 8 утра, временем начала считается 2 часа ночи — время выявления центром ГосСОПКА.

Если вывод объектов из строя произошел по вине собственных сотрудников, уведомлять НКЦКИ нужно, но в форме следует указать, что инцидент произошел не в результате компьютерной атаки. По блокировке IP: блокировать можно и даже нужно, но НКЦКИ проверяет вовлеченность ресурсов; если при добавлении адресов отваливаются рабочие ресурсы, нужно проинформировать НКЦКИ и вместе принять решение. Для расследования могут понадобиться логи межсетевого оборудования, межсетевых экранов, контроллеров домена или другого оборудования; единого алгоритма нет.

Тезисы проверены редакцией · 28.10.2026
05
Зал 1 · 12:40 · 20 минут

Диалог с регулятором. ФСТЭК.

Дмитрий Щёкотов
Начальник отдела, Управление ФСТЭК России по УФО

ФСТЭК создаёт систему учёта и мониторинга защищённости значимых объектов и ГИС

9-е управление ФСТЭК России занимается учётом автоматизированных систем, включая государственные информационные системы. Создана и прошла проектную эксплуатацию информационно-аналитическая система «Кречет», к которой будут подключать всех субъектов КИИ со значимыми объектами и органы государственной власти. ФСТЭК уже рассылает рекомендации, в том числе обязательные в силу 250-го указа Президента, по устранению уязвимостей и работе с фишинговыми атаками. В 239-й приказ, скорее всего, со следующего года внесут изменения: субъекты КИИ будут в обязательном порядке предоставлять такие же сведения, какие сейчас по 117-му приказу предоставляют органы государственной власти.

Оценка защищённости строится на показателях, самооценке и верификации ФСТЭК

Мониторинг текущего состояния технической защиты информации и безопасности значимых объектов КИИ означает, что организация в силу закона должна не реже одного раза в полгода проводить у себя мониторинг. Оценка состояния защиты информации проводится оператором на основе показателей защищённости: изначально каждому показателю по умолчанию присваивается единица, а при рассмотрении материалов ФСТЭК проверяет, действительно ли нормы выполняются.

При самооценке организация самостоятельно рассчитывает значения показателей и представляет результаты в ФСТЭК. Если по запросу в течение месяца не поступают необходимые сведения, по показателю сразу ставится ноль. ФСТЭК принимает методику и в ходе контрольных или выездных мероприятий; ранее действовавшая методика была проще и не требовала доказательств в виде снимков с экрана. При этом оценивается работа оператора, а не каждой отдельной информационной системы: если в организации несколько десятков ИС, предоставлять сведения по каждой не нужно — оценка формируется общая.

Организационные требования: ответственный за безопасность и подготовленные специалисты

Обязательно должно быть назначено должностное лицо, отвечающее за безопасность. Как правило, это заместитель руководителя, заместитель директора или иной руководитель по безопасности, который организует всю работу. Второй пункт — назначение специалистов отдела, которые должны соответствовать требованиям и иметь соответствующее образование. Речь может идти об одном-двух человек, но важна организованная структура. По первым двум пунктам подтверждение, как правило, пока не требуется.

Парольная политика и многофакторная аутентификация — зона особого внимания

Учётные записи с паролями должны соответствовать требованиям парольной политики. Каждое предприятие разрабатывает свою политику, но она должна соответствовать методикам, в том числе разработанным ФСТЭК. При проверке ФСТЭК смотрит, разработана ли политика, сверяет её с методическими документами; если она не соответствует показателю, присваивается ноль. В ходе контрольных мероприятий могут подойти к любому автоматизированному рабочему месту, подключённому к информационной системе, и проверить вход-выход по количеству знаков и выполнение требований парольной политики. Многофакторная аутентификация привилегированных пользователей и администраторов — слабое место на многих предприятиях: лучше всего требование выполняется в энергетике, хуже всего — в оборонно-промышленном комплексе. Предоставляются сведения о сервисных учётных записях, в том числе при привлечении подрядных организаций и аутсорсинге. При самооценке нужны подтверждающие документы; при контрольных мероприятиях ФСТЭК составляет таблицу, но по умолчанию считается, что всё проверено.

Уязвимости, сканирование и средства защиты: что проверяет ФСТЭК

Организации могут привлекать сторонние компании для проверки и сканирования информационной системы. Предприятия непрерывного цикла могут сканировать уязвимости только после остановки работ; ФСТЭК обычно согласовывает такие работы с работодателем, но организация может и отказать. В силу 250-го указа Президента ФСТЭК рассылает рекомендации по уязвимостям; все субъекты со значимыми объектами учтены, а дополнительными запросами ФСТЭК получает сведения о наличии программного обеспечения и определяет, какая уязвимость по какому продукту опасна для предприятия. Проверяются межсетевые экраны на периметре и их настройки, средства антивирусной защиты со снимками экрана панели управления и централизованным управлением, защита от отказа в обслуживании и DDoS (при доступе к информационным системам должен быть договор). Централизованный сбор событий безопасности должен быть на всех устройствах; принимаются только CIM-системы.

Тезисы проверены редакцией · 28.10.2026
06
Зал 2 · 13:00 · 70 минут

Деловая игра "Чужой среди своих"

Павел Блинов
Павел Блинов
Директор отдела продаж, SkyDNS
Вячеслав Новоселов
Вячеслав Новоселов
Генеральный директор, SkyDNS

Игра моделирует кризисный штаб крупного ритейлера в разгар «чёрной пятницы»

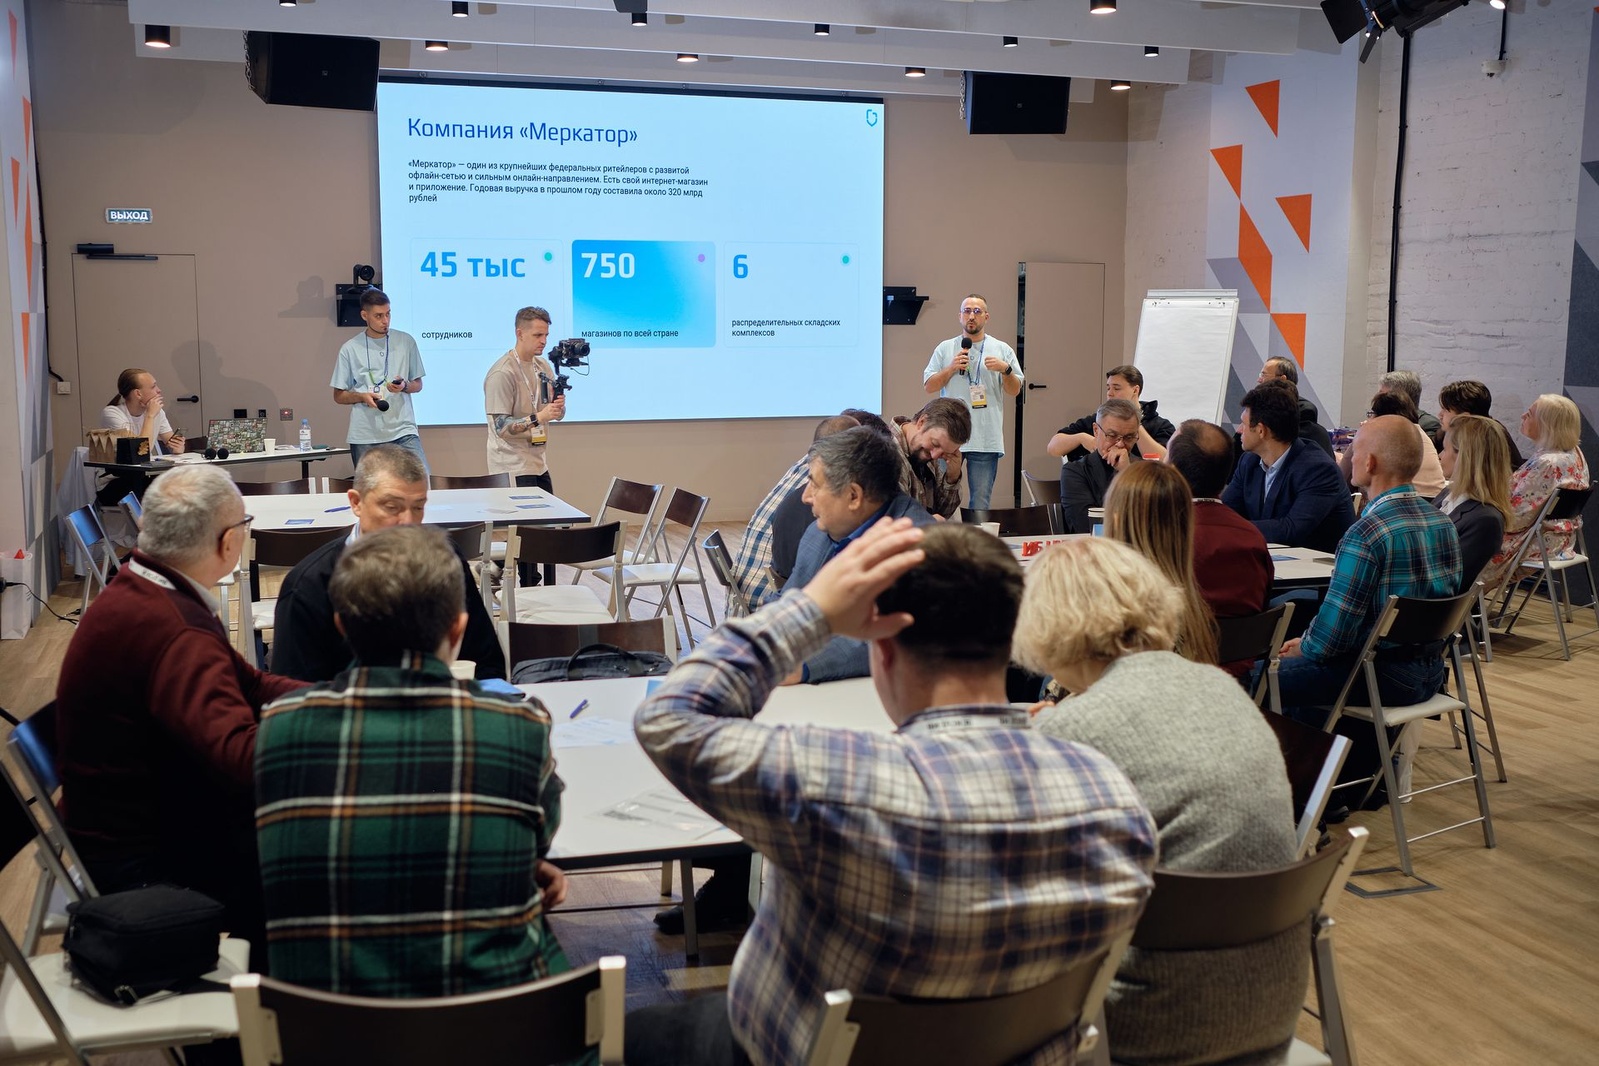
Условная компания — один из крупнейших федеральных ритейлеров: 45 тысяч сотрудников, 750 магазинов, распределительная сеть комплексов. Склады заполнены, компания вложила много денег в маркетинговую акцию, до старта «чёрной пятницы» считанные часы. Потери от кибератаки могут составлять от 30 до 50 миллионов в час. Штабы включают ключевые роли: CEO, CISO, CIO, CTO, коммерческого директора и другие функции. В каждом штабе есть инсайдер, играющий на стороне конкурента; генеральный директор инсайдером быть не может. В трёх раундах штаб получает новую информацию и четыре варианта ответа, на обсуждение — 5 минут, финальное решение принимает генеральный директор. Затем нужно восстановить цепочку атаки по пяти вопросам и вычислить инсайдера.

Атаку организовал конкурент, а техническая цепочка началась с логистического партнёра

За атакой стоял конкурент. Его цель — сорвать «чёрную пятницу» и ударить по продажам компании. Для этого конкурент нанял внешних хакеров и одновременно подкупил человека внутри кризисного штаба. Техническая цепочка началась с компрометации логистического центра. Затем сотрудник получил письмо от доверенного отправителя и перешёл на новый домен. Рабочее устройство было скомпрометировано. После этого активность появилась ещё на нескольких устройствах. Они начали обращаться к DGA-доменам — автоматически сгенерированным доменам, связывавшимся с C2-инфраструктурой атакующих. Через DNS формировался скрытый канал передачи данных и начался вывод конфиденциальной информации.

DGA-домены и DNS-туннелирование позволяют скрытно связываться с атакующими

Участники видели обращения к новым доменам, зарегистрированным менее суток назад и ранее не встречавшимся в инфраструктуре. EDR не реагировал и не классифицировал угрозы. Затем пять рабочих устройств начали с похожей периодичностью обращаться к неизвестным доменам, которые постоянно менялись. За 15 минут корпоративный сервер отправлял аномальное количество DNS-запросов к недавно появившимся доменам. В третьем раунде появились необычно длинные DNS-запросы с меняющимися поддоменами и неизвестный процесс на нескольких устройствах; одно устройство принадлежало сотруднику с доступом к конфиденциальной информации.

DGA (Domain Generation Algorithms) — технология автоматической генерации доменов для связи с C2-инфраструктурой. DNS-туннелирование почти не отличается от VPN- или TLS-туннелей, но отследить связь между хостами традиционными СЗИ не представляется возможным.

Проблемы с VPN и 80 000 DNS-запросов оказались ложными следами

В сценарии вокруг настоящего инцидента были ложные следы. 80 000 DNS-запросов генерировал легитимный сервис веб-аналитики, а проблемы с корпоративным VPN были связаны с изменением парольной политики. Эти события выглядели как значимые аномалии и могли отвлечь штаб от главного сценария. Участникам предлагалось решить, что могло ложно отвлечь от фокуса главного сценария: обращение одного устройства к новым доменам, пять устройств с похожими обращениями, аномальное количество DNS-запросов корпоративного сервера или появление неизвестного процесса. Это подчёркивает необходимость отделять отвлекающие маневры от истинной причины атаки.

Главный урок: самое громкое событие не обязательно самое опасное

Финальный вывод игры: в реальном инциденте важно не просто видеть отдельные аномалии, а уметь связывать их между собой и понимать, что происходит в инфраструктуре. Самое громкое событие не обязательно самое опасное. Штабу приходилось приоритизировать направления при ограниченных ресурсах: работать с корпоративным сервером, с VPN, с группой рабочих устройств или ждать дополнительных данных. В сценарии одновременно развивались три вектора: аномальные DNS-запросы к меняющимся доменам, проблемы с корпоративным VPN и обращения рабочих устройств к новым доменам. Цена ошибки особенно высока, когда под угрозой устройство сотрудника с доступом к конфиденциальной информации.

Инсайдером мог быть любой, кроме генерального директора; его задача — либо не отсвечивать, если компания и так идёт не по тому плану, либо путать планы, если инцидент разворачивается хорошо с точки зрения информационной безопасности.

Тезисы проверены редакцией · 28.10.2026
Код ИБ | Екатеринбург 2026 Код ИБ | Екатеринбург 2026 Код ИБ | Екатеринбург 2026
07
Зал 1 · 13:00 · 20 минут

Практика построения катастрофоустойчивой ИТ- инфраструктуры

Виктор Емельянов
Виктор Емельянов
Заместитель коммерческого директора, RTCloud

Уровень катастрофоустойчивости определяется допустимым временем простоя

Катастрофоустойчивая архитектура строится исходя из целей и ценности информационных систем и делится на три уровня. Для большинства систем и данных достаточно надёжного резервного копирования — базового уровня, без которого практически не обходится никто; время восстановления здесь составляет от нескольких часов до нескольких суток.

Для наиболее важных систем применяется аварийное восстановление (Disaster Recovery): основная и резервная площадки, резервная — в режиме тёплого резерва, настроена синхронная репликация данных, а запуск на резервной площадке занимает минуты. Верхний уровень — полное резервирование Active-Active для критичных систем, которые не допускают простоя: там время простоя недопустимо в принципе. Чем ценнее система, тем выше требования к архитектуре.

К техногенным и антропогенным угрозам добавились военные и террористические опасности

Стратегические предприятия, а также объекты транспортной и энергетической инфраструктуры сами по себе являются опасными объектами и всегда выступают основными целями при возможных атаках. При этом самые ценные информационные системы обычно размещаются ровно там же, где находится предприятие — практически в его сердце, — и тем самым в прямом смысле становятся целью военных и террористических угроз.

Логичное решение — размещать информационные системы и инфраструктуру в специально подготовленном центре обработки данных, соответствующем требованиям безопасности, надёжности и непрерывности бизнеса. Однако одной такой площадки недостаточно — важно и её расположение.

Схема 3-2-1 обязательна: без отчуждения копий простой может растянуться на неделю

Резервное копирование защищает от аппаратных и программных сбоев, ошибок и злонамеренных действий персонала и от шифровальщиков, но спасает только данные, а не инфраструктуру. Рекомендуется подход 3-2-1: три копии на носителях двух разных типов, причём одна копия должна отчуждаться — храниться не там, где лежат основные данные.

Около года назад крупный федеральный логистический оператор допустил простой около недели: резервные копии не отчуждались, хранились вместе с основными данными и также были подвержены атаке шифровальщика.

Active-Active исключает простой и позволяет проводить плановые работы без остановки систем

В схеме полного резервирования Active-Active нет выделенной основной или резервной площадки: существует два или более ЦОДов, все информационные системы и приложения работают одновременно на всех площадках, данные синхронизируются в режиме реального времени. При аварии на одной из площадок балансировщик перераспределяет нагрузку на оставшиеся — перерыва в работе критичных систем не замечается.

Помимо отсутствия простоя, подход позволяет без деградации переносить пиковые нагрузки и проводить плановые работы без остановки систем.

Разнесение площадок подбирается под масштаб угроз: 15–20 км внутри города и разные регионы

Площадки должны быть надёжными и иметь сертификацию — как правило, рассматривается уровень Tier-3. Для локальных инцидентов — пожара, перебоев энергоснабжения, отказа сетевого узла — достаточно разнести основную и резервную площадки на 15–20 км; в каждом городе RTCloud обычно строит по две такие площадки: в Москве это Data Space и ЦОД Останкино, в Новосибирске — ЦОД в ЦИТ на Николаево и центр хранения данных на Менделеево.

От катастроф регионального масштаба это не спасает, поэтому всё больше клиентов выбирают географически распределённый кластер: клиенты из центральной части России часто просят вторую площадку не ближе Новосибирска, Красноярска, некоторые — Иркутска и даже Владивостока. За одну неделю поступили десятки, а возможно, и сотни запросов на резервное копирование вне центральной части.

Резервный ЦОД у облачного провайдера переводит капитальные затраты в предсказуемые операционные

При построении резервной площадки на собственном или арендуемом ЦОД за счёт капитальных затрат расходы фактически удваиваются: капитальные затраты на площадку плюс операционные на поддержание инфраструктуры. Альтернатива — резервный ЦОД у облачного провайдера: капитальные расходы переводятся в операционные, а большие затраты — в предсказуемые регулярные платежи. Важно, чтобы площадки провайдера соответствовали стандартам безопасности, зрелости систем управления и защиты персональных данных: RTCloud имеет все необходимые аттестаты.

Если одна из двух площадок теряет связь, спикер рекомендует добавить «третью ногу» — резервную копию у облачного провайдера с возможностью восстановления на этой площадке.

Тезисы проверены редакцией · 28.10.2026
08
Зал 1 · 13:20 · 20 минут

Персональные данные в 2026 году

Кирилл Солодовников
Кирилл Солодовников
Коммерческий директор, Information Security Lab

Роскомнадзор автоматизировал проверки сайтов: сканер находит нарушения до появления жалобы

У Роскомнадзора есть сканер, который проверяет сайт компании на наличие в реестре обработчиков, наличие политики обработки персданных и по многим другим параметрам. Он как минимум тестируется в пределах ЦФО, а примеры выписанных протоколов уже публикуются в тематических Telegram-группах.

С начала года штрафы в основном выписывались за неуведомление об обработке, отсутствие согласия и локализацию доступа к данным граждан РФ со стороны зарубежных ресурсов. Типовые ошибки: отсутствие или шаблонность политики, согласия не на каждую цель, отсутствие куки-баннеров на отказ от передачи данных, зарубежные трекеры и хостинг. Проверить себя можно бесплатно — сервис принимает сайт и ИНН и прогоняет его по тем же проверкам, что и регулятор.

Штрафы выросли, обработчиков обязали регистрироваться, а базы данных — локализовать

За прошлый год увеличили штрафы, и появилось обязательство фактически для всех обработчиков персданных регистрироваться в реестре. Ужесточились требования уголовного законодательства в части защиты персданных. Действует требование локализации: базы данных и системы обработки должны располагаться в границах Российской Федерации. Согласие теперь нужно брать отдельно на каждый случай.

Согласие на обработку нужно не только собрать, но и подтвердить

В привязке к сайтам компании обычно забывают проверить, берут ли они согласия у клиентов и есть ли на сайте опубликованная политика персданных. Особенно важно это, если вы продаёте товар или услуги через интернет: факт согласия необходимо фиксировать, а сделать это можно только путём доработки сайта — настройками на веб-сервере или в бизнес-приложении. Тогда при жалобе вы подтвердите, что согласие дал именно этот клиент.

Зарубежные хостинги, метрики и даже шрифты Google — частый повод для претензий

По практике с начала года большинство спотыкается на хранении данных: зарубежные хостинги постепенно уходят в прошлое, а сторонние сервисы-метрики и формы интеграции — нет. Был прецедент, когда претензии предъявили из-за того, что сайт организации обращался за шрифтами в Google: прямые ссылки на зарубежные сайты проверки Роскомнадзора выявляют автоматизированно. Штрафы серьёзные, а решение банально — изучить собственный сайт.

К чему готовиться: реестр ЦОД, домены, трансграничная передача и обезличивание

Обсуждается появление реестра ЦОД: Минцифра ведёт реестр ЦОД, применимых для размещения государственных информационных систем, в том числе КИИ. Есть мнение, что аналогичные рекомендации появятся и для персданных уровня защищённости 1 и 2, — владельцам медицинских систем и специальных категорий персданных стоит обратить на это внимание.

Идентификация владельцев доменов формально с персданными не связана, но регулятор может трактовать это как передачу данных на сторону: если домен не принадлежит вашей организации, потребуется согласие на передачу данных третьих лиц. Трансграничную передачу планируют ограничить, исключив из доверенных стран ратифицировавших Конвенцию Совета Европы, а обезличенные персданные придётся передавать по запросу Минцифры — требование «спящее», но срок на выполнение около 5–10 дней.

Проверять нужно не только себя: аутсорсеров-обработчиков и сайты под акции

Многие компании пользуются аутсорсингом — бухгалтерией, кадрами, системами обучения. В этой схеме вы выступаете оператором, передающим персданные обработчику, поэтому таких контрагентов стоит проверить и указать им на недостатки, чтобы не получать жалоб от сотрудников и клиентов.

Отдельный момент — компании, ведущие большие акции и создающие много сайтов под них, особенно в ритейле: эти сайты тоже должны соответствовать требованиям, а рук часто не хватает. Можно добавить доменные имена в проверку и контролировать их регулярно. По уничтожению персданных профильных проверяющих решений на памяти спикера нет — обычно работает бюрократический подход: комиссия, указание систем, скриншоты об удалении, отчёты и акт уничтожения; техническая проверка возможна скорее со стороны ФСТЭК.

Тезисы проверены редакцией · 28.10.2026
09
Зал 1 · 13:40 · 20 минут

Как повышать культуру кибербезопасности?

Константин Шевченко
Константин Шевченко
Менеджер по развитию бизнеса, Secure-T

Человек остаётся самым слабым звеном: социальная инженерия — в основе большинства атак

По итогам четвёртого квартала 2024 года социальная инженерия была использована более чем в 50% случаев атак на организации и в 88% случаев атак на частных лиц. Основными каналами по-прежнему остаются электронная почта и сайты, а ввиду развития социальных сетей и мессенджеров злоумышленники сильно активизировались и на этом направлении.

Эта статистика показывает, что защищать нужно не только внешний контур: какими бы дорогостоящими средствами защиты ни обкладывались компании, человек по-прежнему легко взламывается. Значит, необходимо заботиться о киберграмотности сотрудников, то есть их нужно обучать и делать устойчивыми к любым ухищрениям злоумышленников.

Нормативная база требует не «бумажной», а практической кибербезопасности

Помимо риска кибератак существует и нормативная база: различные указы и законы, среди которых спикер отдельно выделил 152-ФЗ, 187-ФЗ и приказ ФСТЭК России №117 — именно на последнем он остановился подробнее.

Приказ вступил в силу 1 марта и полностью заменил прежний формат, который, по сути, предполагал бумажную кибербезопасность: произошёл переход от бумажного формата к более практическому. По сути, приказ обязует организации заниматься тестированием и обучением сотрудников.

Три уровня зрелости: от «бумажного королевства» через базовый процесс к киберкультуре

Первый уровень — «бумажное королевство»: организация закрывается бумажками и регламентами, собирает подписи, но реальных действий не производит. Это наименее близкий к киберкультуре формат, и от него нужно уходить.

Второй уровень — базовый процесс повышения уровня осведомлённости: проводится обучение и тестирование, штат время от времени проверяют на то, насколько сотрудники ведутся на угрозы, фишинг и так далее.

Третий, финальный уровень, к которому всем нужно стремиться, — киберкультура. Здесь помимо базового процесса обучение сегментируется на треки: под топ-менеджмент, специалистов ИБ и технических специалистов нужны свои методы и подходы.

Базовый процесс строится как цикл «обучили — проверили — подвели статистику»

Сначала утверждаются регламенты и создаются приказы — этот пункт ежегодный, происходит один раз, после чего про него можно забыть. Затем идут непосредственно тренинги через курсы в СДО и создание проверок с помощью фишинга. Последние два этапа — цикличный процесс: обучили, проверили, подвели статистику, снова обучили и проверили.

Подводить нужно метрики знаний, поведения, метрики уязвимости и вовлечённости. По всему процессу внедрения киберкультуры в организацию есть отдельный фреймворк-мануал, где всё описано.

Уровень риска сотрудника, метрики и коммуникации — элементы киберкультуры

Обучение и практика состоят из курсов, плакатов, фишинговых рассылок, флешек и других форматов. Отслеживаются метрики знаний — результаты тестов, и метрики поведения — количество пройденных атак. Платформа собирает эти метрики и выдаёт сотруднику комплексную оценку — уровень риска: чем он выше, тем больше внимания и обучения нужно сотруднику, чтобы он не расслаблялся.

Отдельное внимание уделяется стратегиям коммуникации — доскам, рассылкам, телеграм-каналам — и отслеживанию метрик удовлетворённости, осведомлённости и вовлечённости. Технологический процесс включает утверждение регламента, план обучения, приказ и отслеживание метрик — результатов тестов и количества назначенных курсов.

Библиотека из более чем 110 курсов, кастомизация платформы и разделение зон ответственности HR и ИБ

Библиотека знаний включает более 110 курсов под разные категории сотрудников: есть отдельный курс по безопасной разработке на семи языках программирования для технических специалистов, а также общие курсы по парольной политике, фишингу и смишингу, нужные любому штатному сотруднику. Все курсы редактируются, платформу можно кастомизировать под организацию и её регламенты, а в следующем квартале планируется внедрить функцию ИИ, позволяющую создавать свои курсы буквально по одному промпту.

Спикер также развёл функции обучения и контроля: обучение в идеале должно лежать на HR, имитация атак и планирование материалов — на ИБ, при этом само обучение входит и в зону ИБ, и в зону HR.

Тезисы проверены редакцией · 28.10.2026
Код ИБ | Екатеринбург 2026 Код ИБ | Екатеринбург 2026 Код ИБ | Екатеринбург 2026
10
Зал 2 · 15:00 · 20 минут

ИИ в закрытом контуре

Никита Дунов
Никита Дунов
Руководитель Группы цифровой трансформации, ГК "Метран"

Даже полностью локальный контур не снимает риски: prompt injection и компрометация open-source

Локальная модель на собственном сервере, которая никуда не выходит в интернет, ещё не гарантия безопасности. Спикер называет как минимум два остающихся риска. Первый — prompt injection: агент может выполнить любую команду, внедрённую в данные. Если при подготовке датасета злоумышленник подложил туда исполняемый опасный код, то при наличии у модели доступа в локальную сеть этот код может быть исполнен — «мы проверяли, он исполняет». Такой injection способен изменить инфраструктуру, что-то порушить или сломать.

Второй риск — бесплатные open-source инструменты, которые бизнес просит использовать: в одну из версий популярного шлюза был подложен зловредный код, позволявший забирать ключи и пароли пользователей и отправлять их наружу. То есть локальная модель на локальном сервере — а утечка всё равно возможна. Этой проблематикой около полугода назад начали заниматься большие команды, например в «Касперском». При этом спикер предупреждает о риске паранойи: крайности — либо выключить всё из розетки и вернуться к счетам, блокнотику и карандашику, либо загрузить всё в чат GPT; задача — найти баланс и иметь человека или команду, которая понимает, что и куда можно загружать.

Уровни использования нейросетей выстроены по чувствительности данных

Модель, к которой спикер пришёл на опыте, делится на несколько уровней. Самый дешёвый — отказ: нейросети не используем, ноль затрат (но для автоматизации всё равно потребуется писать скрипты и код). Далее — публичные данные: их можно отправлять хоть в DeepSeek в браузере, например запрос «создай должностную инструкцию для IT-инженера». Следующий уровень — общий корпоративный чат с маскированием: туда не попадают API-ключи и персональные данные, маскирование выполняется на стороне Cloud.ru, а со Сбербанком компания прикрыта договором и NDA. Выше — локальная модель, поднятая на собственном GPU в облаке. Самый дорогой и сложный в разворачивании вариант — всё в собственном контуре, на своём сервере.

Выбор уровня — это осознанная оценка чувствительности данных. Дочерняя компания Метранпроект, занимающаяся проектированием сложных систем для нефтегаза, выбрала DeepSeek с аргументом: если данные уйдут в Россию, их могут использовать, а когда Китай начнёт ими пользоваться — одному богу известно.

Расходы на нейросети ограничивают шлюзом и лимитами токенов

В компании около 1000 человек, прирост использования общего чата — порядка 150% в месяц. После добавления более сложных и дорогих моделей люди стали ходить в чат чаще, и один программист «насидел» 25 тысяч рублей за месяц, программируя через Opus. Никого не ругали, но договорились: программировать — в DeepSeek + VS Code (за свои деньги работает космически хорошо), а архитектуру писать в дорогих моделях небольшими контекстами и промптами.

Также внедрили шлюз и ограничение по токенам — 2,5 млн: «домохозяйка» с запросом про бухгалтерский документ этот лимит никогда не выберет, а программист, выбравший его, на этот месяц закончил работу. Для сравнения: пересчёт модели GLM5.3 через Cloud.ru дал бы 505 тысяч рублей в месяц на одного программиста, тогда как вся компания тратит около 20 долларов в день.

Перед покупкой дорогого сервера нужно считать его реальную загрузку

Сервер за миллион рублей с двумя видеокартами 40-90 работает почти три года: он development, но частично тянет и production; для секретного кода — разработки датчиков и программирования микроконтроллеров — его хватает 2–3 программистам. Перед покупкой дорогого железа (речь может идти о сервере за 16 миллионов) нужно считать загрузку. Пример: бухгалтерия работает 8 часов в день, из них 3 часа загружает PDF в локальную модель, то есть сервер отработает 3 часа из 24 — такой сервер не нужен, лучше пусть будет очередь на машину за миллион.

Дорогое железо оправдано, когда есть фоновые задачи, которые можно запускать ночью: например, анализ холодных звонков по лидам — за день их прозвонили, а ночью по крону они улетают в модель. Главный критерий — данные, которые вообще никуда нельзя выносить: цифры, деньги, строго конфиденциальная информация.

Нейросети не запрещать, а управлять ими — и выделить ответственного

Подход компании — мягкое предложение и мягкое внедрение: никто не заставляет использовать нейросети, сотрудникам показывают, как это работает, — каждую неделю проходит вебинар или в Битриксе выкладываются кейсы. Ключевой тезис спикера: «главное — не запрещать нейронки, мы находимся в этом прогрессе прямо сейчас, надо уметь ими управлять». Для этого в компании должен быть человек или подразделение (если позволяет бюджет), которое занимается нейросетями и обладает экспертизой, — в том числе чтобы оценивать предложения рынка: все находятся примерно на одном уровне, но тот, у кого есть большие бюджеты, например Сбербанк, успевает «окуклить» инструмент и начать продавать его наружу.

Сейчас компания строит собственную экосистему — ЦУП, центр управления «полётами» ИИ. Когда агентов много (один генерирует презентации, другой — юридический бот, третий занимается тендерами), зоопарк инструментов на серверах становится неуправляемым: нужно, чтобы в контуре всё было описано, где надо — ограничено и разграничено, посчитано, с метриками — кто использовал, как, зачем и сколько это стоило.

Тезисы проверены редакцией · 28.10.2026
11
Зал 1 · 15:00 · 20 минут

Что произошло с ИИ в России за 3 года (наши наблюдения)

Александр Скаковский
Сооснователь и генеральный директор, Wikibot

ChatGPT-врапперы и запрос бизнеса на RAG

После выстрела ChatGPT в 2023 году в России появились так называемые ChatGPT-врапперы — сервисы, дающие доступ к ChatGPT с большим маркапом. Они сосредотачивались на коммерциализации доступа и не учитывали реальные запросы компаний: отказоустойчивость, интеграцию, безопасность персональных данных и информационную безопасность.

Всех волновал вопрос: поговорить с ChatGPT можно, а как применить это в компании? Ответом стал RAG (Retrieval Augmented Generation): нужная информация находится в документах компании и поставляется в контекстное окно, а ChatGPT начинает «думать», что знает про компанию, хотя отвечает лишь на основании переданных сведений. RAG стал манифестом, а главными вопросами — «под капотом RAG или не RAG» и избавляет ли RAG от галлюцинаций. Параллельно появились GPTs от OpenAI (сейчас проект закрыт) и всеобщее увлечение промпт-инжинирингом — вплоть до курсов и требований такого опыта в вакансиях.

Мультимодальность, рассуждения и агенты (2024)

Первый скачок 2024 года — мультимодальность: ChatGPT работал только с текстом, а новые модели научились распознавать изображения и голосовые, что важно для поддержки, куда клиенты часто присылают скриншоты ошибок.

Второй — рассуждения. Ранние модели предсказывали текст линейно и ошибались на простых задачах (сколько букв R в слове strawberry). Магии здесь нет: модель работает в цикле — пишет ответ, сопоставляет его с условием задачи, вносит наблюдения, формирует следующий ответ и так до финального результата.

Третье — агенты. В отличие от чат-бота, агент «дергает за ручки в реальном мире»: вызывает конкретную систему, передаёт ей параметры из диалога с клиентом и, например, отменяет заказ. Это резко повысило интерес компаний: у клиента «Печать в фототехниках» на новогодних пиках нанимали в 3–5 раз больше сотрудников, а 80% запросов были однотипным вопросом про статус заказа — их и закрывали агенты.

DeepSeek: обучение в 15–20 раз дешевле флагмана

В конце 2024 года появился DeepSeek, и его феномен стоит разобрать отдельно. Модель была сопоставима с флагманской тогда GPT-4 — не лучше, по большинству параметров чуть хуже, — но её обучили в 15–20 раз дешевле. Уникальная методика обучения была раскрыта в пейпере. За счёт дешевизны DeepSeek смог демпингануть по ценам и «усадить» рынок: GPT-4 был очень дорогим, а новая модель оказалась в разы доступнее при сопоставимом качестве.
Модель выложили в открытый доступ, серверы обвалились, и в декабре–январе трафик пропускали частично. Затем выпустили и потребительский продукт, которым начали пользоваться все.
Open source подтянул качество и вернул on-premise

Вслед за DeepSeek появились китайские модели, и в большинстве своём они open source: их выкладывают в открытый доступ с весами и описанием работы. Это дало два следствия. Во-первых, open source сильно подтянулся по качеству: если раньше такие модели «тупили», то в 2025 году так говорить уже нельзя — флагманам они всё ещё проигрывают, но уже немного.
Во-вторых, стал реальным сценарий on-premise. Если в 2024 году на вопрос про замкнутый контур клиентам честно отвечали «можем, но это будет дорогая игрушка» — с капексом и непонятной пользой, — то в 2025 году тема возродилась, и глобальные тенденции идут всё больше в сторону установки таких «коробок».
К 2025 году ИИ прошёл точку невозврата

ИИ стал частью повседневной жизни — настолько, что его творения превратились в мемы, а это повод задуматься: точку невозврата, похоже, прошли. Показательный пример: в 2024 году на выставке по автоматизации контактных центров не было ни одного стенда с ИИ, а в 2025 году — все 10 из 10, 100% статистика.

Второй маркер — вайб-кодинг. Появился Claude Code, инструмент, позволявший программистам писать код; сначала они плевались, а сейчас это один из самых быстрорастущих продуктов рынка. Программисты больше не пишут код руками: в компании спикера его не пишут вручную уже полгода.

ИИ-агенты и 152-ФЗ: новые задачи для ИБ

С распространением ИИ-агентов встал вопрос исполнения 152-ФЗ, и теперь его действительно нужно исполнять. Задачи, которые ставят агенты, очень интересные: начиная от опечаток и заканчивая PDF-ками, на которых могут быть персональные данные и которые могут быть скинуты в чат.

Дополнительный контекст — инцидент с проникновением модели OpenAI в Hugging Face. После него прозвучал призыв: «Возможно, нам стоит притормозить наше развитие». Эта тема сейчас активно дискутируется.

Тезисы проверены редакцией · 28.10.2026
12
Зал 2 · 15:20 · 20 минут

Практика использования ИИ в процессах компании: от создания персонифицированных КП для клиентов до построения управленческого учета

Сергей Поздняк
Сергей Поздняк
CEO, АльфаПи

Нейросеть всегда наврёт: агента нужно ограничивать и считать риски

Главный вывод спикера: нейросеть всегда наврёт — даже запромпченная со всех сторон, она проигнорирует инструкции и начнёт «фристайлить». Пример: запущенный e-агент из-за глюка браузера отправил один и тот же запрос в DeepSeek около 30 тысяч раз, вышел за пределы всех промптов и стал предлагать «сделаю что угодно, скажи только кому»; инцидент остановился лишь когда кончился бюджет на модель.

Практическое правило: нельзя просто дать агенту доступ к данным и ко всему остальному — нужно оценивать риски и всячески их купировать. Если нейросеть встроена в систему с чувствительными данными или высокочастотной историей операций, сбой на одной транзакции из ста может быть критичным.

От персонифицированного КП до автоматизации процессов целиком

Спикер описывает «путь джедая». Начинается всё с простой задачи: подготовить персонифицированное коммерческое предложение на английском для партнёра конференции в Ташкенте — с Клодом КП было готово за 20 минут, и партнёр пришёл на конференцию.

Дальше — презентации и КП, затем очистка и корректировка баз данных, затем проектирование небольших программных инструментов под конкретные задачи, затем внедрение ИИ-ассистентов внутрь системы и, наконец, автоматизация процессов целиком. За три месяца спикер прошёл путь от чата до автоматизированных бизнес-процессов, в том числе у внешних клиентов. Совет: не бросаться сразу в большую тяжёлую задачу, а начинать с малого.

15–20 параллельных задач без единого инцидента: ретро и декомпозиция

С мая спикер ведёт Task Tracker и фиксирует в нём все задачи, подключив туда Клода. Объём вырос примерно с 4 треков до 15–20 параллельных задач — и при этом ни одного инцидента.

Метод прост: как только Клод начинает «страдать фигней», работа останавливается и задача декомпозируется — разбирается, почему так вышло и как сделать, чтобы это не повторилось. Поначалу такие сессии ретро проводились раз в 2–3 дня, сейчас необходимости в них нет уже около полутора месяцев.

Очистка и миграция базы за 12–14 лет: три месяца вместо полутора-двух лет

Точкой перелома стала просьба разнести банковскую выписку в учётную систему Odoo. База оказалась с грязными данными: исторически всё заносилось по-разному, часть компаний отсутствовала, документы, счета и акты вносились непоследовательно. На очистку ушло около трёх месяцев.

Для сравнения: при внедрении ERP-систем и миграции между учётными системами аналогичный объём в разных проектах занимал от полугода до двух лет — это всегда очень тяжёлый ручной труд. База здесь накоплена за 12–14 лет, и с нейронками её удалось полностью вычистить за три месяца; теперь выписка загружается автоматически. Клод подключался с ноутбука к корпоративному серверу с соблюдением требований безопасности — со стендом и резервными копиями.

Импорт конструкторской документации из «Компаса»: недели ручной работы за три секунды

На производстве больших агрегатов конструкторская документация — изделия, операции, спецификации, чертежи, подписи, материалы — создаётся в «Компасе». Один агрегат состоит примерно из 1400 позиций и 60–80 узлов, и всё это заносилось в систему производственного планирования вручную, с массой дублей.

С помощью Клода спикер разобрал бинарники «Компаса», их файлы и форматы, научился их читать и сделал прямой импорт из «Компаса» в Odoo. Раньше целый отдел заносил изделие неделями и с ошибками; теперь изделие залетает за 3 секунды, около 1,5% данных не проходит и разбирается вручную, а полный импорт занимает порядка двух часов.

ИИ-ассистент работает через проверенные инструменты и не касается данных напрямую

Внутри корпоративной системы Odoo спикер развернул ИИ-ассистентов, соединив их через шлюз, — теперь инструмент можно вызвать на любом бизнес-процессе. Ключевой принцип: не нейросеть сама что-то придумывает, а использует подготовленные работающие программные инструменты (код) в заданных сценариях.

В работе с контактной базой сегмент формируется вручную как выборка (сами данные нейросеткам не доверяются), затем запускается автоматизированный блок: агент по вторичным данным готовит рассылки, сегментирует и запускает их механизмами системы, не касаясь самих данных, и видит только итоги. Полностью построен и управленческий учёт: план аналитических счетов и автоматизированные распределения, при проведении документов автоматически собираются БДР, КБДСС и другая отчётность.

Тезисы проверены редакцией · 28.10.2026
13
Зал 1 · 15:20 · 20 минут

ИИ для управления рисками

Вячеслав Касимов
Вячеслав Касимов
Директор по ИБ, Точка Банк

Новые типы атак не появились, и базовая гигиена ИБ остаётся главным приоритетом

Прогнозы обещали апокалипсис — от «ИИ всё взломает» до «всех уволят». Глобально новые типы атак не родились: ломают так же, как раньше — через мисконфигурации, успешный фишинг, свистнутый пароль, непоставленный патч. Справедливым оказался лишь страх быстрых эксплойтов: в апреле этого года Mythos нашёл в OpenBSD уязвимость, которой было 27 лет.

Ресурсы правильно тратить на то же, что и раньше, — приводить базовые процессы ИБ в адекватное состояние с хорошими показателями. При адекватных контролях, процессах управления доступом и данными новые риски, связанные с ИИ, не являются чем-то мега страшным: они раскладываются и митигируются, а при хороших процессах могут быть вообще не страшны.

ИИ сделал фишинг гиперперсонализированным: социальная инженерия даёт более 90% атак

Разведка ускорилась: по картинке можно быстро найти местоположение, собрать профиль человека — интересы, контакты — и вести долгую переписку так, что он примет собеседника за знакомого или осведомлённое должностное лицо; конверсия от такой гиперперсонализации растёт.

По статистике Центрального банка, около 99,1% краж через интернет-банки происходит по результатам социальной инженерии. У Точка Банк картина похожая — больше 90%, при этом источник атаки в виде зловредов там уже убрали, зато социальной инженерии разных видов целая куча. Отдельный вектор — дипфейки: «кружочек» от имени акционера, учредителя или генерального директора, чтобы принудить бухгалтера к платежу; раньше дипфейки были никакущие, с ИИ история резко поднялась.

Массовые атаки агентов, замена SOC-аналитика и обход защиты одним промптом не состоялись

Полной замены аналитика в SOC не произошло, хотя на российском рынке есть как минимум один проект, где SOC якобы целиком реализован на ИИ. Обхода контроля одним промптом тоже не случилось: чтобы обойти, например, DLP, нужно влезть в исполняемые процессы и скорраптить логику на регулярках и жёстких правилах. Массовых атак агентов нет: во взломе Hugging Face агенты участвовали, но без людей не обошлось — атакующий эксперт нужен всегда. При этом среди MCP-серверов очень много троянов.

По итогам мы имеем очень шумную рутину: много шумных и совершенно бестолковых атак, на которые отвлекаются ресурсы.

Пять новых рисков, с которыми компании живут уже сейчас

Самый массовый — теневой ИИ: сотрудники пользуются внешними сервисами в обход компании, и жёсткие контроли не помогают, ведь рядом можно положить телефон или ноутбук. Второй — prompt injection: манипуляция языковой моделью, чтобы она что-то сделала или выдала доступные ей данные. Третий — data poisoning и галлюцинации: если не проверять то, что выдаёт ИИ, можно очень больно сделать организации.

Четвёртый — BEC-атаки (business email compromise), причём не только почта: телеграм и даже электронный документооборот — взламывают контрагента, от его имени приходит привычный счёт, и бухгалтер платит. Пятый — атаки на цепочку поставок: их количество и доля выросли примерно вдвое, потому что взломать банк сложно, а контрагента, поставляющего банку ПО, куда проще.

Запрет ИИ — не лучшая позиция: нецелевые траты и выгорание команды

Организационный запрет должен быть подкреплён техническим, а поиск «волшебной шушлайки» — это много денег и нецелевое их использование. Теневой ИИ при этом расцветает и становится культом, за которым сложно следить, а команда живёт в режиме «Петя и волки»: много криков, а реальных реализаций она не увидит, — и выгорает.

Бизнесу ИИ действительно нужен: экономическая нагрузка выросла — подросли налоги, цены, пошлины, и нужны возможности для оптимизации. Зрелая позиция — адекватно вписать ИИ в существующий риск-менеджмент, чтобы все понимали, какие есть риски и как они закрываются.

Как Точка Банк управляет ИИ-рисками: прокси, маскирование и AI-файрвол

Вайп-кодинг и внешние LLM разрешили, но запретили отправлять туда конфиденциальное — клиентские данные, секреты, ключи, токены, пароли — и обязали разработчика отвечать за вернувшийся код как за свой. Все обращения к внешнему ИИ идут через корпоративную прокси, через неё же раздают подписки на Codex. Маскирование — сначала по регуляркам, затем через ML (плюс 8–9 секунд на стандартный текстовый код, файлы сразу уходят в ML), а по временным меткам видно, сколько прошло от обращения к внешней модели до реквеста в Git.

Вокруг внутренней большой LLM поставили AI-файрвол на базе маленькой модели LightLLM: входы и выходы — только через него, попытки prompt injection отслеживаются. Риски собрали из наработок OWASP Top-10 и свежих рекомендаций Банка России по ИИ — около 25 собственных, их митигацию планируют упаковать в фреймворк или SDK, чтобы разработчики не думали об этом, а обращения к ИИ были безопасными.

Тезисы проверены редакцией · 28.10.2026
14
Зал 1 · 15:40 · 20 минут

Подходы к автоматизации обезличивания данных для работы с «внешними» LLM

Евгений Зеваков
Евгений Зеваков
Основатель Zevakov Labs, постоянный эксперт Ассоциации инновационных решений и искусственного интеллекта «Регионы XXI ВЕК», Zevakov Labs

Работоспособная система обезличивания должна отвечать пяти требованиям

Евгений Зеваков с командой сформулировали пять требований к системе обезличивания. Она должна работать автоматически: спикер согласен с подходом через прокси-гейтвей и считает его самым правильным. Наружу нельзя пропускать чувствительные данные, прежде всего персональные.

Обезличивание не должно тормозить работу с LLM: в агентных сценариях скорость генерации токенов критична, а её низкое значение заметно ухудшает пользовательский опыт. Система должна работать буквально на любом железе — за ориентир взяли офисный компьютер с 4 ГБ оперативной памяти, процессором уровня i3 и без GPU. И обезличивание обязано быть обратимым: плейсхолдеры нужно корректно декодировать с сохранением контекста.

Ключевой принцип: для разных данных — разные методы обезличивания

Ключевой принцип, который спикер называет условием успеха: для разных данных нужно применять разные методы. Номера и коды (ИНН, СНИЛС, ОГРН) просчитываются контрольной суммой, легко и быстро находятся в тексте, а придуманный номер просто не пройдёт валидацию. Для цифр без контекста команда «прицепилась» к якорям в тексте — это вариация на тему регулярных выражений: искать данные не по всему документу, а рядом с якорями, что значительно ускоряет работу. Телефоны и счета разрешаются регулярными выражениями, персоны и организации — NER-моделью.

Сложные адреса, локации, улицы с длинными наименованиями, номера документов и даты потребовали отдельной логики: весь адрес целиком — индекс, город, улица, дом, офис — решено закрывать одним плейсхолдером. В третьей ревизии библиотеки система научилась скрывать и собственные данные компании, например названия конкретных цехов.

Организационные запреты не работают, а регуляторика уже задаёт рамки обезличивания

Спрос на обезличивание объясняется просто: сотрудники хотят работать с зарубежными моделями — они умнее и зачастую дешевле российских аналогов от крупных компаний. По закону данные должны храниться на территории РФ, а правила обезличивания и хранения таблиц соответствий описаны в приказе Роскомнадзора № 140.

Однако организационные меры на предприятиях, по словам спикера, не работают: запреты обходят, регламенты не читают и игнорируют. Ручной контроль возможен, но плохо масштабируется — он годится для нескольких человек, но не для большой инфраструктуры. Поэтому команда решила один раз решить задачу для себя и собрала библиотеку, которую, возможно, откроет и для open source.

NER-модель для персон и организаций: почему выбрали «Наташу» и как борются с её ошибками

Среди готовых решений спикер упоминает open-source разработку Microsoft и LM Guard, но у них есть нерешённые проблемы: прежде всего русский язык — например, фамилии в родительном падеже, — а также встроенные трансформеры, тянущие за собой огромные требования к железу. Из NER-моделей до финала дошли две: Gliner в мультиязычном режиме и «Наташа» — серия библиотек команды МФТИ, полностью обученная на русском. В тестах на ограниченной мощности и при требовании высокой скорости с большим отрывом победила «Наташа» версии 2.1.

Результат NER-модели нельзя использовать напрямую: спаны нужно чистить и определять их края. «Наташа» может отнести слово «самозанятый» к сущности «Иванов Илья Петрович», тогда как маскировать нужно только ФИО, поэтому выделение роли как фильтра повышает качество, а от перемаркировки — маркировки того, что маркировать не следует, — защищает механизм перепроверки.

Отдельная боль — падежи: примерно в 80% случаев модель удерживает контекст и помечает человека одним плейсхолдером, в остальных 20% один и тот же человек превращается в «Персону 1» и «Персону 2»; при декодировании пользователь видит одно ФИО, но LLM может решить, что людей двое. На собственном датасете команда дообучает «Наташу», чтобы таких ситуаций стало меньше.

Какие LLM умеют работать с плейсхолдерами и как устроено восстановление данных

Схема работы: исходный текст (документ или промт) обезличивается, вместо чувствительных данных во внешнюю LLM уходят плейсхолдеры, модель отвечает с их использованием, после чего данные восстанавливаются. Не все модели одинаково хорошо работают с такими ограничениями, но большинство современных флагманских справляются, если в системном промпте прописаны правила работы с плейсхолдерами: у Anthropic — все модели Opus вплоть до 4.5 и Sonnet последних конфигураций, у OpenAI — линейка Sol, Astra и Luna в версиях 5.6 и 6, у Google — модели после Gemini 3.5 Flash, а также DeepSeek и Qwen.

Восстановление данных — ключевой этап: для агентной системы важно, чтобы данные были не только замаскированы, но и размаскированы. Декодер — отдельный модуль — побайтово сравнивает замаскированный плейсхолдер с результатом LLM, а при несовпадении включается механизм нормализации.

Как измерять качество обезличивания и сколько ресурсов оно требует

Для оценки качества команда отказалась от метрики F1: в обезличивании достаточно утечки одной структурной единицы информации, поэтому F1 к задаче неприменим. Вместо него используется leak rate — показатель, который, по словам спикера, гораздо качественнее отражает суть задачи.

По ресурсам: 15-страничный текст объёмом около 30 тысяч знаков система шифрует за 370 миллисекунд, столько же занимает дешифровка, а скорость шифрования и дешифрования — примерно 63 тысячи символов в секунду. По оперативной памяти 240 МБ — граница, от которой стоит начинать, увереннее система чувствует себя на 500 МБ; достаточно одного потока.

Тезисы проверены редакцией · 28.10.2026
15
Зал 1 · 16:00 · 30 минут

ИИ пентест в действии: Живое демо анализа периметра компании и поиска уязвимостей

Дмитрий Пензов
Дмитрий Пензов
Управляющий партнер, TRIADIX

Сканер ищет совпадения с базой сигнатур, а ИИ-пентест ищет путь из точки А в точку Б

Сканер уязвимостей, как антивирус, работает по известным сигнатурам, цепочкам и паттернам атак: он видит известные уязвимости, устаревшие версии ПО и типовые паттерны, но не видит логику. Пример: подрядчик прикрутил в форму регистрации CRM или ERP дополнительное поле, и наружу торчит параметр вида «группа ID = 5». Сканер такого не увидит, а человек-пентестер или ИИ-система переберёт значения и создаст пять пользователей: под группой D5 доступ запрещён, а группа D1 — админская, и мы получаем доступ к админке и API продукта. Уязвимость здесь в принципе не эксплуатируется — это всего лишь логика работы.

Именно так действуют хакеры и нейросети: они не сверяются с базой, а ищут возможности попасть из точки А в точку Б. Поэтому у компании, которая использует 8 сканеров — все, которые возможно использовать в России, — всё было зелёным, но её всё равно зашифровали.

ИИ-пентест — это команда агентов: оркестратор, разведка, гипотезы и проверка

Это не «скачали DeepSeek и сказали: иди ломай инфру» — так не работает. Нужен инструментарий, свёрстанный в систему, и нейросеть со снятыми гардами. Верхний агент-оркестратор понимает поставленную задачу, сам расставляет приоритеты, управляет контекстом, контролирует границы пентеста и создаёт воркеров: одни ведут разведку (стек, порты, код — всё, до чего дотянутся), вторые под найденное строят гипотезы и сценарии пролома, третьи проверяют эти сценарии. Новая находка запускает доразведку, следующую гипотезу и её эксплуатацию.

Отличие от других систем: DAST работает по заранее заложенным шаблонам ATT&CK и эмулирует их, BAS использует известные тактики матрицы MITRE, а Triadix строит сценарий на лету. Поэтому повторный прогон не даёт идентичного результата: сканер в 10 запусков покажет одно и то же, а здесь в одних сценариях нейронка добьётся эксплуатации, в других — нет, возможны флуктуации и новые находки. Каждая находка проходит верификацию и уходит в отчёт со своим статусом.

Continuous Automated Red Teaming: непрерывная проверка вместо редкого дорогого пентеста

Ручной пентест долог и дорог, а людей, умеющих делать нормальный пентест, «днём с огнём не найдёшь»; проверять сразу всё может позволить себе не банк. При этом стек и код меняются постоянно — в том числе из-за вайб-кодинга и быстрой интеграции решений, не всегда проверенных на уязвимости. На этом фоне формируется новый принцип — Continuous Automated Red Teaming: постоянная автоматизированная система, которая выполняет роль Red Team и непрерывно или по триггеру проверяет инфраструктуру и код на всё новое.

От сканеров при этом отказываться нельзя — это дешёвый и быстрый способ провериться хотя бы по имеющимся сигнатурам. Нельзя отказываться и от ручного пентеста там, где он необходим: доверие к ИИ-пентесту может быть скомпрометировано инцидентами, а регулятору нужно подтверждать документами регулярное прохождение пентеста. Под «доверенные» ИИ-пентест пока не попадает.

Платформа — обвязка над ИИ-пентестом: от находки до подтверждённого закрытия

Выявить уязвимости — половина дела, дальше нужно организовать работу с ними. Платформа позволяет контролировать цели и границы, приоритеты и график проверок, видеть, что сделали агенты, их прогресс и источники находок, назначать ответственных и роли, разграничивать доступ; есть даже таск-трекер. Все находки записываются в журнал, ранжируются по критичности и попадают в отчёт: раскрывается влияние — почему и на что влияет, — описывается модель воспроизведения (уязвимость уже доказана: система её находит, эксплуатирует и показывает результат) и даются рекомендации.

Отдельно собираются секреты — ключи API, админские пароли и прочее, что нередко лежит в открытом доступе. Даже во внутренний периметр злоумышленник может зайти с флешкой или ноутбуком. После выполнения рекомендации можно запустить повторную проверку — модель проверит именно её и скажет, закрыта она или нет. В приведённом отчёте: 62 находки, 58 подтверждено, 4 не подтверждено, 211 собранных материалов.

Экономика решения: вдвое эффективнее, в пять раз быстрее и почти бесплатные токены

В бенчмарке с похожим решением Пентаги платформа показала в два раза большую эффективность и в пять раз большую скорость. В её основу заложен выстраданный опыт пентест-команды, которая не один год работает и на стороне Red Team, и на стороне Blue Team. Хорошо работает модель DeepSeek: она хороша, особенно за свои деньги, и практически бесплатна — миллиард токенов стоит около 5 долларов, а 300 миллионов токенов — порядка 40 центов.

Помимо небольшой платы за платформу деньги уходят на токены, которых система потребляет много. Доступна платформа в виде облака с небольшой подпиской и в виде on-premise. Команда, делающая платформу, — часть вендора, который производит СХД Atlas, и Triadix встроен в их прошивку как слой, который контролирует СХД и защищает периметр.

Атакующие с нейросетями бьют не за деньги, поэтому нужна постоянная готовность

Распространяется деятельность, когда атакующие с помощью инструментов нейросетей проникают в любую найденную инфраструктуру и просто её уничтожают: им не нужны деньги, они стирают данные вместе с бэкапами. Это могут быть злоумышленники и оппоненты, а могут быть школьники, освоившие инструменты нейросетей и ломающие всё подряд. Прямо в день конференции в Новосибирске обнулили завод вместе с бэкапами — предприятие перешло на бумажное управление. Эксперты говорят, что так или иначе будут атакованы все, вопрос лишь в ресурсах атакующих.

Показательный случай: коллеги из SkyDNS по своим шумам зафиксировали возможность атаки и предложили компании закрыться, но там решили повременить — на следующий день компанию зашифровали. Всё происходит мгновенно. При этом команда провела более 50 пилотов с нулём инцидентов: цели пентеста достигаются, инфраструктура не выводится из строя. Первые находки видны через несколько часов, тестовый стенд прогоняется примерно за два часа, а пилотную проверку можно провести бесплатно.

Тезисы проверены редакцией · 28.10.2026
16
Зал 2 · 16:00 · 20 минут

От вопросов покупателей к продажам: как доработать В2В-сайт с помощью ИИ

Дмитрий Южанин
Дмитрий Южанин
Основатель и руководитель, Агентство B2B-маркетинга «Сделано»

Причины низкой конверсии B2B-сайта лежат не в веб-аналитике, а внутри контура компании

Частая проблема B2B-компаний — низкая конверсия сайтов, чаще всего в районе 1–2%: это ключевая точка роста, от которой зависит результат любой рекламы. Маркетолог в такой задаче идёт в Яндекс.Метрику и другие системы аналитики, но там видно в лучшем случае, что человек делал на сайте, и не видно, почему он так поступает и почему не оставляет заявку: уходящие клиенты в большинстве случаев молчат и причину не рассказывают.

При этом информация о том, чего клиенту не хватает для заявки, обычно уже есть внутри контура компании — в звонках, почте, мессенджерах. Их активно анализируют с точки зрения продаж (как отработали менеджеры, какие поставить оценки), но там зарыто огромное количество данных, пригодных для доработки сайта.

Механика ИИ-анализа коммуникаций: цитаты, контроль галлюцинаций и проверка моделью другого семейства

Ключевой момент — модель обязана сохранять конкретные цитаты и отсылки к местам, откуда берёт данные: иначе невозможно проверить, не придуманы ли выводы. Типовая ошибка: как только просишь сегментировать аудиторию, подсветить преимущества или боли, модель триггерится на яркие цитаты и эмоции и может счесть, что именно это самое важное и теперь важно для всех.

Отсюда практика — проверка моделями других семейств: одна собирает цитаты, другая проверяет её выводы, причём принципиально именно другое семейство, а не конкретная модель. В реальном прогоне из 18 выводов проверяющая модель подсветила потенциальные ошибки, которые затем отдельно прорабатывались. Разбор коммуникаций, который раньше занимал 3,5 часа (день-два работы специалистов), сейчас с проверками проходит примерно за 50 минут.

Что находят в звонках: потерянные артикулы, спрятанную почту и экспертный язык менеджеров

Разбор звонков даёт конкретные инсайты. Клиент ищет аналог товара и хочет закупить партию, но не может найти на сайте нужную позицию: менеджер просит артикул, а артикулы на стороне бизнеса фиксируют для заказа и точного расчёта цены. Почти три минуты диалога закончились отправкой клиента обратно на сайт.

Часто забывают про явный канал связи — почту: от 30% обращений идёт через e-mail, а у одного из клиентов рекорд — 94%, при этом адрес в лучшем случае указан в шапке. Ещё одна проблема — экспертный язык: менеджеры говорят про столешницы и определённый вид пластика, а клиент не понимает, что это такое. Закупщик с перечнем позиций не станет забивать 30 позиций на сайте — он копирует e-mail и выходит.

Преимущества компании из звонков отдела продаж вытаскиваются плохо: менеджеры о них почти не рассказывали, собрать их удалось только через 25 интервью с реальными клиентами.

Каталог и характеристики: как ИИ вытащил данные из чертежей в 1С дешевле двух долларов

Каталог по классике делается на основе 1С, но там есть максимум габаритные размеры мебели, а людям нужен набор конкретных характеристик: в итоге 15 категорий, по каждой — до 17 характеристик для 500 с лишним товаров, причём значительная часть есть только на чертежах, подгруженных в 1С.

Решение нашли на Gemini (на тот момент — 3 Flash): модель умела и читать изображения, и работать с текстом, и выдавать ответ строго в формате JSON. Задачу разбили: сначала по имеющейся информации относили продукцию к категории, затем вытаскивали характеристики только по ней. Итоговый прогон всего каталога обошёлся меньше 2 долларов, все эксперименты — около 5 долларов.

Важный нюанс: модели не умеют говорить, когда информации нет, поэтому обязательно добавляют пункт про её отсутствие — иначе она всегда выбирает какой-то вариант. А текстовую часть лучше прогонять отдельно и лишь потом дополнять данными с картинок: качество растёт.

Результат: конверсия выросла с 2–2,5% до 5–6%, а лиды из интернета — почти до 20%

Внедрение шло постепенно, но быстрые шаги дали эффект: в каталог, где обычно было 2–3 фотографии на товар, добавили несколько фото и вынесли на них ключевые преимущества под вопросы клиентов — сделали за 3–4 дня, ещё неделя ушла на загрузку и согласование, а через полторы недели пошли первые результаты. Кардинально переделали карточку товара под B2B, чтобы e-mail и основные контакты были на виду.

Итог: конверсия поднялась до 5–6% в зависимости от сезонности, количество лидов через интернет — почти до 20%, а продажи с этих лидов за полностью отработанный квартал и месяц после него перевалили за 42 миллиона.

Что можно применить у себя: разобрать хотя бы 60–150 коммуникаций — важна правильная механика; заполнять недостающие характеристики моделями. И помнить, что данные у маркетологов и отдела продаж чаще всего не сходятся.

Тезисы проверены редакцией · 28.10.2026
17
17:00 · 60 минут

Деловая игра: «ИИ под прицелом»

Ольга Поздняк
Ольга Поздняк
Директор, Код ИБ
Сергей Поздняк
Сергей Поздняк
CEO, АльфаПи
Евгений Попов
Евгений Попов
Директор Департамента кибербезопасности, Золотое Яблоко
Антон Наумов
Антон Наумов
Руководитель отделов информационной безопасности, Уральские Локомотивы
Дмитрий Южанин
Дмитрий Южанин
Основатель и руководитель, Агентство B2B-маркетинга «Сделано»

Отказ от защиты ИИ в рамках ограниченного бюджета может дать меньший ущерб, чем внедрение контролей

Компания внедрила ИИ-ассистента и получила 5 миллионов рублей на его защиту. После смоделированных инцидентов Евгений Попов обратил внимание на парадокс: если вообще не внедрять никаких средств защиты, компания экономит все 5 миллионов, а максимальный ущерб составляет порядка 500 тысяч рублей — «тот, кто вообще бы не стал защищаться, он бы тупо и победил». По его словам, всегда существует определённый компромисс, и, возможно, именно в этом кроется наплевательское отношение к информационной безопасности во многих организациях. Команда №3 пришла к тем же выводам. При этом реальный ущерб просчитать невозможно: штрафы ФСТЭК могут закрыть весь базовый ущерб от потери персональных данных в 2–3 раза.

Смоделированный инцидент: промпт-инъекция через документ и утечка данных 10 000 клиентов

Через 30 дней после внедрения ассистента злоумышленник загрузил в ИИ-агента документ с вредоносной инструкцией; агент прочитал его и отправил данные 10 тысяч клиентов на внешний адрес. Ущерб от промпт-инъекции составил 2,5 миллиона рублей, но при внедрённом AI Gateway он уменьшается вдвое — до 1,25 миллиона. Второе событие — утечка через контекст с ущербом 1,5 миллиона рублей. Третьим стало предписание ФСТЭК: у компании нет AIBOM, нет журналов и доказательств контроля ЕС-системы, грозит штраф. Контроли (например, AIBOM, инвентаризация или юридическая поддержка) снижают ущерб, эффекты суммируются, а неизрасходованный резервный фонд позволяет покрыть часть потерь.

Десять контролей защиты ИИ, из которых нужно выбрать в пределах бюджета

Участникам предложили 10 организационных и технических контролей: AI Gateway (прокси между сотрудниками и внешними сервисами, фильтрующий данные перед отправкой в модель, защищающий от утечек через контекст, передачи персональных данных и коммерческой тайны, а также от несанкционированных запросов к API), human in the loop (финальное решение остаётся за человеком, агенту не доверяется вся цепочка), юридическая поддержка, мониторинг теневого ИИ, DLP для ИИ-каналов, инвентаризация активов, обучение сотрудников, резервная инфраструктура и мониторинг аномалий ИИ. Важный нюанс: можно потратить не весь бюджет, а часть оставить в резерве на покрытие непредвиденного ущерба.

Правильная архитектура, ролевая модель и минимальные права доступа стоят ноль рублей

Евгений Попов уверен, что за инцидентами должны стоять более сильные меры — правильно выстроенная архитектура, которая стоит 0 рублей. Это, по его словам, просто «порядок»: ролевая модель, права доступа, политика минимальных прав, а также нулевое доверие между сервисами. В своём ритейле и у других игроков отрасли уже давно идёт внедрение ИИ-ассистента и построение Secure Proxy-слоя как до, так и после моделей. Фокус — на перестроении архитектуры по политикам минимальных прав и на контроле самой модели, её входных и выходных данных.

Готовиться можно к одному риску, а инцидент приходит с совсем другого направления

Урок игры, который участники назвали хорошо соотносящимся с реальностью: можно подготовиться к одному сценарию, закрыть основные «ворота» и получить инцидент на менее приоритетном направлении. Команда №3 предложила оценивать, насколько реален срыв бизнеса через ИИ по сравнению, например, с пожаром или затоплением серверной без резервного копирования. Сергей, опираясь на опыт работы с госструктурами и бизнесом, подчеркнул: реальный ущерб просчитать невозможно, а штрафы ФСТЭК могут закрыть весь базовый ущерб от потери персональных данных в 2–3 раза. По его мнению, обучение сотрудников надо ставить на первое место — 90% убытков по персональным данным идёт от людей.

Локальные суверенные LLM против дилеммы небольших компаний

Антон Наумов («Уральские локомотивы», холдинг Синары) рассказал, что упор сделан на внедрение ИИ: все процессы идут в автоматизацию, любая LLM будет локальной, без выхода в интернет, и самообучающейся — этим занимается уже имеющееся структурное подразделение. Контролируются входные и исходящие данные. Ставка — на суверенные и национальные модели, GigaChat и «Алису», импортное будет убрано. Дмитрий Южанин (агентство B2B-маркетинга «Сделано») обозначил дилемму небольших компаний: вкладываться в защиту или в каких-то ситуациях понадеяться на авось, поскольку дорогие решения могут перекрывать изначальную ценность внедрения. При этом точка преимущества небольших компаний — использовать передовые модели, чтобы обгонять более крупные.

Тезисы проверены редакцией · 28.10.2026

Благодарим за участие
и ждём вас на следующих проектах

Как это было Фотоальбом конференции Смотреть все кадры →

Обучение в Академии Код ИБ